
- 월간 방문 수
- 0
- 가격
- 무료 및 유료
- 등록일
- 2026-08-13
- 업데이트됨
- 2026-08-13
01dots.tts란 무엇인가
dots.tts는 샤오홍슈 dots 팀과 상하이교통대학교 X-LANCE 연구실이 공동 오픈소스한 20억 파라미터 규모의 완전 연속 자기회귀 음성 합성 기반 모델입니다. 모델은 연속 잠재 공간에서 48kHz 오디오를 블록 단위로 직접 생성하며, Seed-TTS-Eval 등 벤치마크에서 음색 유사도와 콘텐츠 정확도 SOTA를 달성하고, 제로샷 음성 복제, 스트리밍 출력 및 저지연 전이중 대화를 지원합니다. 프로젝트의 전체 코드와 가중치를 공개했으며, dots.tts.edit를 확장해 정밀한 음성 편집 기능도 제공합니다.
02dots.tts의 주요 기능
제로샷 음색 복제: 3–10초의 참고 오디오만으로 해당 음색으로 임의의 새 텍스트를 읽을 수 있으며, 다국어 복제를 지원합니다. Seed-TTS-Eval 벤치마크에서 콘텐츠 정확도와 화자 유사도 모두 SOTA 성능을 달성했습니다.
텍스트 음성 합성: 무작위 음색 샘플링부터 특정 화자 지정까지 고품질 음성 생성을 제공하며, 2B 파라미터 연속 자기회귀 모델을 기반으로 48 kHz 오디오를 직접 출력합니다.
스트리밍 생성 및 저지연 상호작용: 기본적으로 스트리밍 출력을 지원해 텍스트 프롬프트가 입력되면 오디오를 블록 단위로 생성합니다. 1T1A 이중 스트림 모드에서는 상위 LLM이 텍스트 Token을 하나 출력할 때마다 음성 측이 즉시 응답하며, 오디오 첫 패킷 지연 시간이 최저 54.4밀리초에 불과해 실시간 음성 Agent와 전이중 대화에 적합합니다.
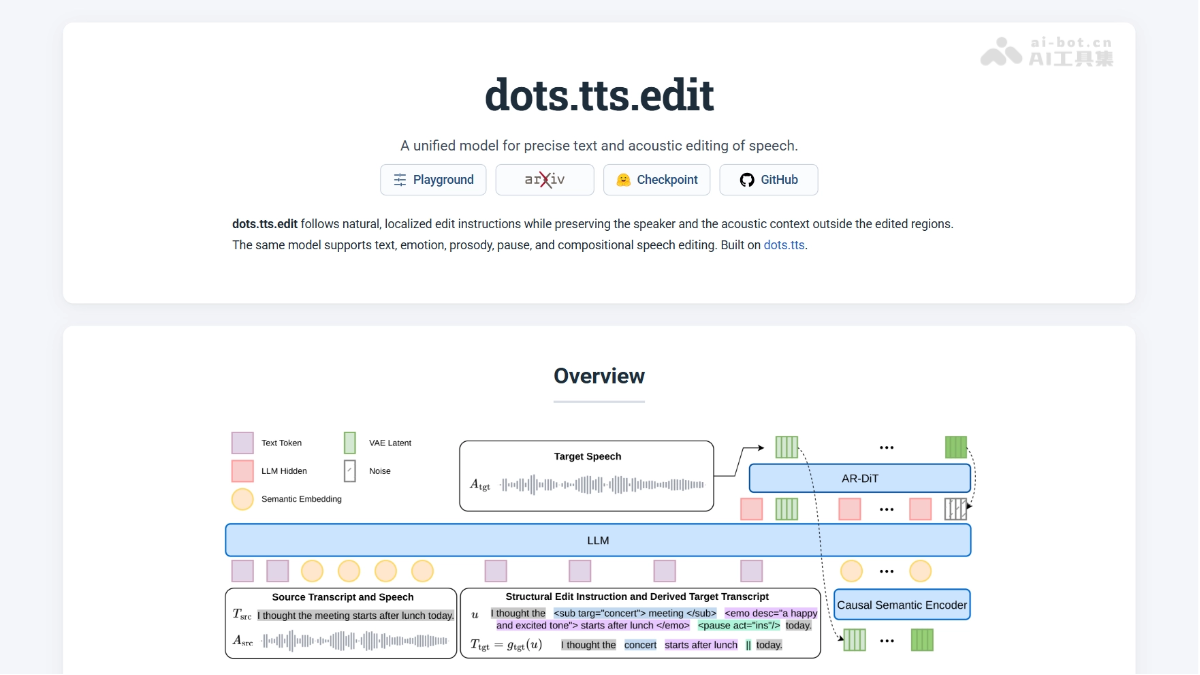
정밀한 음성 편집: 기존 녹음의 텍스트 교체, 감정 조절, 음높이 및 말하기 속도 수정, 쉼표 삽입 또는 삭제를 지원합니다. 여러 작업을 하나의 명령으로 조합해 한 번에 처리할 수 있으며, 편집하지 않은 영역은 그대로 유지됩니다.
다국어 지원: 24개 언어를 지원하며, MiniMax 다국어 평가에서 평균 화자 유사도 83.9를 기록했고 19개 언어에서 개별 1위를 차지했습니다.
다양한 추론 속도: Base, SOAR, MeanFlow(4단계), 2단계 sCM, 1단계 DMD 등 여러 체크포인트를 제공해 사용자가 음질과 추론 속도 사이에서 필요에 따라 선택할 수 있습니다.
03dots.tts의 기술 원리
WeChat에서 팔로우 후 “开源”라고 답장하여 AI 오픈소스 프로젝트 교류 그룹에 참여하세요.
완전 연속 자기회귀 아키텍처: dots.tts는 기존 방식처럼 음성을 이산 Token으로 양자화하지 않고, 전체 생성 과정을 연속 잠재 공간에서 수행합니다. 모델은 자기회귀 방식으로 음향 조각을 블록 단위로 예측한 뒤 BigVGAN 스타일 디코더를 통해 48 kHz 파형으로 복원합니다. 이를 통해 이산 양자화로 인한 정보 병목과 음색 세부 정보 손실을 근본적으로 방지합니다.
의미 기반 연속 표현: HoliTok 설계를 기반으로 한 AudioVAE를 사용해 원시 파형을 25 FPS의 연속 잠재 변수로 압축합니다. 인코더는 의미 기반 학습을 통해 복원 충실도와 잠재 공간의 구조화 사이에서 균형을 이루며, 복원된 화자 유사도 0.969를 달성합니다. 이를 통해 후속 자기회귀 생성에 풍부한 음색 및 음향 세부 정보의 상한을 보존합니다.
오차 제어 메커니즘: 연속 자기회귀에서 앞 단계의 작은 편차가 뒤로 누적·확산되는 고유한 문제를 해결하기 위해 dots.tts는 인과적 의미 인코더를 도입했습니다. 이미 생성된 VAE patch를 실시간으로 압축해 간결한 의미 이력으로 만들고 이를 대규모 언어 모델에 다시 입력합니다. 고분산의 국소 음향 변화를 분리하고 장거리 의미 요약만 유지함으로써 긴 시퀀스 생성에서 오차 전파, 발진음 및 음색 변이를 효과적으로 억제합니다.
생성 과정: 생성 과정은 대규모 언어 모델을 중심으로 진행됩니다. 이 모델은 Qwen2.5-1.5B를 기반으로 초기화되며, BPE 텍스트 Token을 직접 입력받아 각 단계의 은닉 상태를 출력합니다. 이후 자기회귀 흐름 매칭 헤드(18층 DiT)가 LLM 은닉 상태와 자기회귀 프롬프트를 조건으로 다음 음향 patch를 디노이징 생성합니다. 동시에 동결된 CAM++ 화자 인코더가 제공하는 전역 x-vector를 사용해 음색의 일관성을 보장합니다.
후처리 학습을 통한 가속: 팀은 SOAR 자기 교정 정렬을 통해 학습 중 실제 추론에서 발생하는 이탈 상태를 시뮬레이션하고 모델이 스스로 수정하도록 학습시켜, 보상 모델 없이도 안정성을 향상했습니다. MeanFlow 증류를 사용해 교사의 다단계 궤적을 평균 속도로 압축하여 4단계 고품질 생성을 구현했으며, 간소화된 일관성 모델(sCM)을 통해 2단계로 압축했습니다. 또한 보상 인식 분포 매칭 증류(DMD)와 이중 시간 척도 업데이트 전략을 결합해 자연스럽고 선명한 고품질 1단계 모델을 얻었습니다.
04dots.tts 사용 방법
설치: pip install dots.tts를 실행해 설치하거나, GitHub에서 소스 코드를 클론한 후 pip install -e .로 로컬 개발 설치를 진행할 수 있습니다. 고동시성 환경에서는 SGLang Omni를 추가로 배포해 CUDA Graph 가속과 연속 배치 처리를 지원할 수 있습니다.
명령줄 합성: dots.tts 진입점을 사용하고 --model-name-or-path, --text, 대상 --prompt-audio 및 --prompt-text를 지정하면 제로샷 음색 복제를 수행할 수 있습니다. --prompt-text를 생략하면 x-vector 복제로 전환되고, --prompt-audio를 생략하면 무작위 음색 샘플링을 수행합니다.
명령줄 편집: dots.tts.edit 진입점을 사용하고 --source-audio와 XML 형식의 --instruction을 제공하면 기존 녹음의 텍스트 교체, 감정 또는 운율 수정 등 정밀한 편집을 수행할 수 있습니다.
Python API 기본 호출: DotsTtsRuntime.from_pretrained()로 모델을 로드한 후 generate()를 호출하고, 텍스트와 선택적 참고 오디오를 전달하면 합성 오디오 텐서를 받아 파일로 저장할 수 있습니다.
Python API 스트리밍 출력: generate_stream()을 호출하면 오디오 텐서를 블록 단위로 가져올 수 있어 플레이어 또는 WebSocket으로 실시간 전송하고 생성과 재생을 동시에 수행하는 저지연 환경을 구현할 수 있습니다.
Python API 이중 스트림 대화: DotsTtsRuntimeDoubleStreaming으로 세션을 시작한 후 텍스트를 Token 단위로 전송하면 음성 측 생성이 즉시 시작됩니다. 오디오 첫 패킷 지연 시간은 최저 54.4밀리초이며 실시간 음성 Agent에 적합합니다.
미세 조정: accelerate launch scripts/train_dots_tts.py를 실행하고 자체 데이터 경로를 설정하면 공개 체크포인트를 기반으로 음색 또는 도메인 적응 미세 조정을 수행할 수 있습니다.
증류 가속: scripts/train_dots_tts_meanflow.py를 통해 SOAR 체크포인트를 교사로 사용해 MeanFlow 증류를 수행하면 4단계, 2단계 또는 1단계의 고품질 학생 모델을 얻을 수 있어 다양한 지연 시간과 동시성 요구에 대응할 수 있습니다.
웹 인터페이스: python apps/gradio/app.py를 실행해 시각적 합성 인터페이스를 시작하거나, apps/edit_playground/app.py를 실행해 Edit Playground를 시작하면 브라우저에서 오디오를 업로드하고 편집 구간을 표시한 뒤 결과를 실시간으로 미리 볼 수 있습니다.
05dots.tts의 핵심 장점
연속 잠재 공간 모델링: 이산 음향 Token을 없애고 연속 잠재 공간에서 직접 자기회귀 생성하여 스펙트럼 질감과 숨소리 등 풍부한 음색 세부 정보를 보존하며, 복원 화자 유사도는 0.969에 달합니다.
SOTA 합성 품질: Seed-TTS-Eval 벤치마크에서 콘텐츠 정확도와 음색 유사도 모두 SOTA를 달성했으며, 24개 언어 MiniMax 평가에서 평균 SIM 83.9를 기록해 종합 성능이 주요 솔루션을 앞섭니다.
네이티브 스트리밍 및 저지연: 1T1A 이중 스트림 모드의 오디오 첫 패킷 지연 시간은 최저 54.4밀리초이며, SGLang Omni를 사용하면 단일 H100에서 16개 동시 스트림 기준 처리량 4.76 req/s를 달성해 실시간 음성 Agent 요구를 충족합니다.
통합 편집 기능: dots.tts.edit는 동일한 기반 모델을 사용하며 XML 구조화 명령을 통해 텍스트, 감정, 운율 및 쉼표를 정밀하게 편집할 수 있습니다. doteBench 평가에서 다른 오픈소스 시스템을 전반적으로 앞섰습니다.
06dots.tts 프로젝트 주소
GitHub 저장소:https://github.com/studio-dots-ai/dots.tts
arXiv 기술 논문:https://arxiv.org/pdf/2608.02673
07dots.tts의 활용 분야
실시간 음성 Agent: 1T1A 이중 스트림 모드의 첫 패킷 지연 시간이 최저 54.4밀리초로, LLM 기반 실시간 전이중 대화와 음성 비서에 적합합니다.
제로샷 음색 복제: 몇 초의 참고 오디오만으로 어떤 음색이든 복제할 수 있고 다국어 복제를 지원해 오디오북, 더빙 및 개인화 콘텐츠 제작에 적합합니다.
다국어 콘텐츠 생성: 24개 언어를 지원하면서 높은 화자 유사도를 유지해 글로벌 제품의 다국어 음성 안내와 현지화 서비스에 적합합니다.
정밀한 음성 편집: dots.tts.edit를 사용해 기존 녹음의 텍스트 교체, 감정 조절, 운율 수정 및 쉼표 조정을 수행할 수 있어 팟캐스트 후반 작업과 오디오 콘텐츠 정밀 편집에 적합합니다.
라이브 스트리밍 및 실시간 안내 방송: LLM 스트리밍 출력과 결합해 생성과 재생을 동시에 수행할 수 있어 뉴스 방송, 라이브 커머스 및 실시간 정보 안내에 적합합니다.
© 면책 조항: 도메인 및 연결된 콘텐츠는 시간이 지나면서 변경될 수 있습니다. AIEZZ은(는) 제3자 웹사이트를 관리하지 않습니다. 외부 콘텐츠와 위험을 독립적으로 검토하세요.
사용자 리뷰0