
- 월간 방문 수
- 0
- 가격
- 설정되지 않음
- 등록일
- —
- 업데이트됨
- 2026-09-10
01AuK란 무엇인가
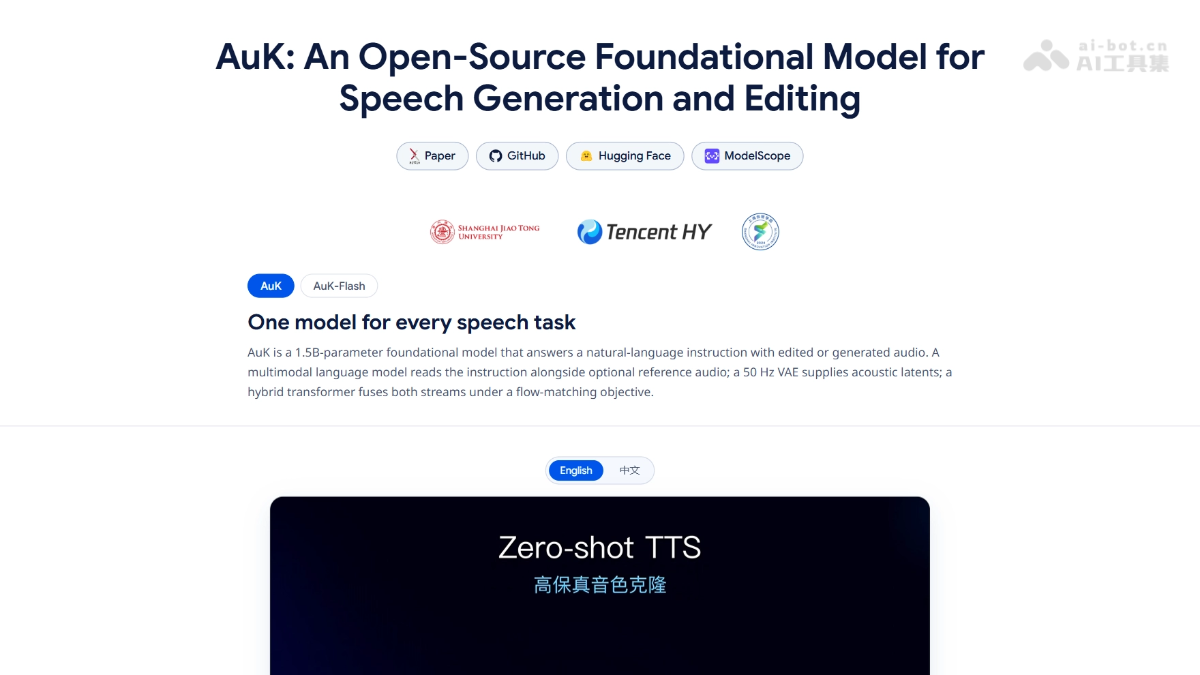
AuK는 텐센트 혼위안이 오픈 소스로 공개한 15억 개 파라미터의 음성 생성 및 편집 기반 모델로, 자기회귀 방식이 아닌 플로 매칭 확산 아키텍처를 사용합니다. 모델은 통합된 자연어 지시 인터페이스를 통해 제로샷/지시형 TTS, 음성 콘텐츠 편집, 음향 조절, 비언어적 요소 편집, 노이즈 제거 및 음성 분리 등 16가지 음성 작업을 수행할 수 있습니다. 4단계 추론을 지원하는 AuK-Flash 고속 버전도 제공하며, 속도가 약 4.5배 향상됩니다.
02AuK의 주요 기능
Zero-shot TTS: 몇 초 분량의 참조 오디오로 음색을 복제하고 새로운 음성을 합성합니다.
Instruct TTS: 참조 오디오 없이 음성 특성을 텍스트로 설명하기만 하면 해당 음성을 생성합니다.
음성 콘텐츠 편집: 음색과 억양을 변경하지 않고 녹음된 음성의 텍스트를 교체, 삽입 또는 삭제합니다.
가사 편집: 멜로디와 노래의 특성을 유지하면서 가사만 다시 씁니다.
음높이/속도/볼륨 편집: 반음, 배속, 데시벨 단위로 음향 속성을 정밀하게 조절합니다.
감정 및 음색 편집: 가사를 바꾸지 않고 감정적 색채를 변경하거나, 콘텐츠를 유지한 채 음색을 변환합니다.
억양 편집 및 노이즈 제거: 억양을 제거하고 노이즈와 잔향을 줄여 선명도를 높입니다.
비언어적 요소 편집: 숨소리, 웃음소리, 기침을 추가하거나 제거하여 일반 음성과 속삭임을 서로 변환합니다.
음성 분리: 말하는 순서에 따라 여러 사람의 오디오를 분리하거나, 콘텐츠 설명에 따라 대상 화자의 음성을 추출합니다.
음악 분리: 노래에서 보컬을 추출하고 반주를 제거합니다.
03AuK의 기술 원리
WeChat에서 “开源”를 팔로우하고 답장하여 AI 오픈 소스 프로젝트交流群에 참여하세요.
전체 패러다임: AuK는 플로 매칭 확산 아키텍처를 사용해 오디오 잠재 공간 표현을 생성하므로 ‘편집’ 작업에 자연스럽게 적합합니다. 원본 오디오의 잠재 표현을 노이즈 제거의 시작점으로 삼고 지시된 부분만 수정하여 원래의 음색, 멜로디 및 편집되지 않은 콘텐츠를 더욱 잘 보존합니다. 이것이 편집 작업군을 포괄할 수 있는 기술적 기반입니다.
3중 구성 파이프라인 아키텍처: 시스템은 세 부분으로 구성됩니다. 멀티모달 대규모 언어 모델은 자연어 지시와 참조 오디오를 읽고 의미 조건을 생성합니다. 오디오 VAE는 24kHz 파형을 50Hz 음향 잠재 공간으로 인코딩합니다. 핵심 혼합 Transformer는 10개 층의 양방향 MMDiT와 20개 층의 단방향 DiT를 쌓은 구조이며, 모델 차원은 1536, 총 파라미터 수는 15억 개입니다.
대규모 지시 정렬 학습: 학습 데이터는 약 30.3억 개의 “지시—오디오” 쌍으로 구성되며, 유효한 지도 데이터는 총 약 195만 시간에 달합니다. 핵심은 모든 작업을 동일한 “지시 + 입력 오디오 → 출력 오디오” 형식으로 통일하여, 단일 인터페이스를 통해 16가지 작업으로 일반화할 수 있도록 한 것입니다.
후속 학습 및 인간 선호도 최적화: 모델은 기본 학습 후 인간 선호도 최적화와 강화학습 후속 학습(RL post-training)을 거쳐 생성 음성의 자연스러움, 지시 준수도 및 청취 품질을 향상합니다.
04AuK 사용 방법
하드웨어 환경 확인: 약 24GB급 VRAM을 갖춘 NVIDIA GPU(예: RTX 3090/4090)를 준비합니다.
코드 저장소 복제: GitHub에서 Tencent-Hunyuan/AuK 저장소를 로컬로 복제합니다.
의존 환경 설치: 저장소 요구 사항에 따라 Python 환경을 구성하고 필요한 의존 패키지를 설치합니다.
모델 가중치 다운로드: Hugging Face 또는 ModelScope에서 AuK 가중치와 관련 VAE 파일을 다운로드합니다.
의미 조건 모델 다운로드: 지시와 참조 오디오를 분석하는 멀티모달 대규모 언어 모델 Qwen2.5-Omni-3B를 별도로 다운로드하고 구성합니다.
입력 자료 준비: 대상 텍스트, 참조 오디오 또는 편집할 원본 오디오 파일을 준비합니다.
자연어 지시 작성: 작업 요구 사항에 따라 음성 특성 설명, 교체할 문장 지정, 음높이/속도 조절 등을 지시문으로 작성합니다.
추론 실행: 명령줄(CLI)을 통해 지시와 자료를 입력하고 생성 또는 편집을 실행한 뒤 결과를 기다립니다.
청취 및 조정: 결과 오디오를 확인하고, 만족스럽지 않으면 지시문 표현, 샘플링 단계 수 또는 CFG 강도를 조정하여 다시 생성합니다.
05AuK의 핵심 장점
통합 인터페이스로 작업을 폭넓게 지원: 자연어 지시를 통해 TTS, 편집, 향상, 분리 등 16가지 음성 작업을 수행할 수 있어 작업별로 모델을 따로 배포할 필요가 없습니다.
업계에서 드문 편집 기능: 단어 교체, 문장 삽입, 음높이 조절, 감정 변경 등 정밀한 편집을 지원하며 원래의 음색과 억양을 최대한 보존합니다.
Instruct TTS는 참조 오디오가 불필요: 음성 특성을 텍스트로 설명하기만 하면 음성을 생성할 수 있어 사용 진입 장벽을 낮춥니다.
플로 매칭 아키텍처로 높은 충실도 제공: 토큰별 예측이 아닌 확산형 생성을 사용하며, 편집 시 원본 오디오를 시작점으로 노이즈를 제거하므로 수정되지 않은 부분의 손상이 거의 없습니다.
06AuK 프로젝트 주소
프로젝트 공식 사이트: https://auk-project.github.io/
GitHub 저장소: https://github.com/Tencent-Hunyuan/AuK
HuggingFace 모델 저장소: https://huggingface.co/tencent/AuK
arXiv 기술 논문: https://arxiv.org/pdf/2609.08936
07AuK의 활용 분야
영화/숏폼 드라마 후반 작업의 대사 복원: 배우가 대사를 잘못 말했거나 대본을 조금 수정해야 할 때 녹음된 음성의 특정 단어나 문장만 직접 교체하여 재녹음 없이 원래 연기의 감정을 유지합니다.
팟캐스트 및 인터뷰 제작: 말실수와 불필요한 말을 삭제하고, 말하기 속도와 리듬을 조절하며, 배경 소음과 잔향을 제거하여 초벌 편집 자료를 한 번에 완성본으로 정리합니다.
오디오북 및 AI 더빙 제작: Instruct TTS로 캐릭터 설명에 따라 차별화된 음색을 생성하고, 동일한 내레이터의 감정과 억양도 후처리로 조정하여 여러 캐릭터 제작 비용을 줄입니다.
음악 창작 및 2차 창작: 원래의 멜로디와 노래 특성을 유지한 채 커버곡 가사를 다시 쓰거나, 노래에서 보컬을 추출해 리믹스 소재로 활용합니다.
언어 훈련 및 접근성应用: 억양이나 언어 장애가 있는 사용자의 억양을 보정하고 말하기 속도와 볼륨을 조절하여 더욱 명확하고 이해하기 쉬운 음성 콘텐츠를 생성합니다.
© 면책 조항: 도메인 및 연결된 콘텐츠는 시간이 지나면서 변경될 수 있습니다. AIEZZ은(는) 제3자 웹사이트를 관리하지 않습니다. 외부 콘텐츠와 위험을 독립적으로 검토하세요.
사용자 리뷰0