
- ماہانہ وزٹس
- 0
- قیمتیں
- متعین نہیں
- فہرست میں شامل
- —
- اپ ڈیٹ شدہ
- 2026-09-21
01WebCraftBench کیا ہے
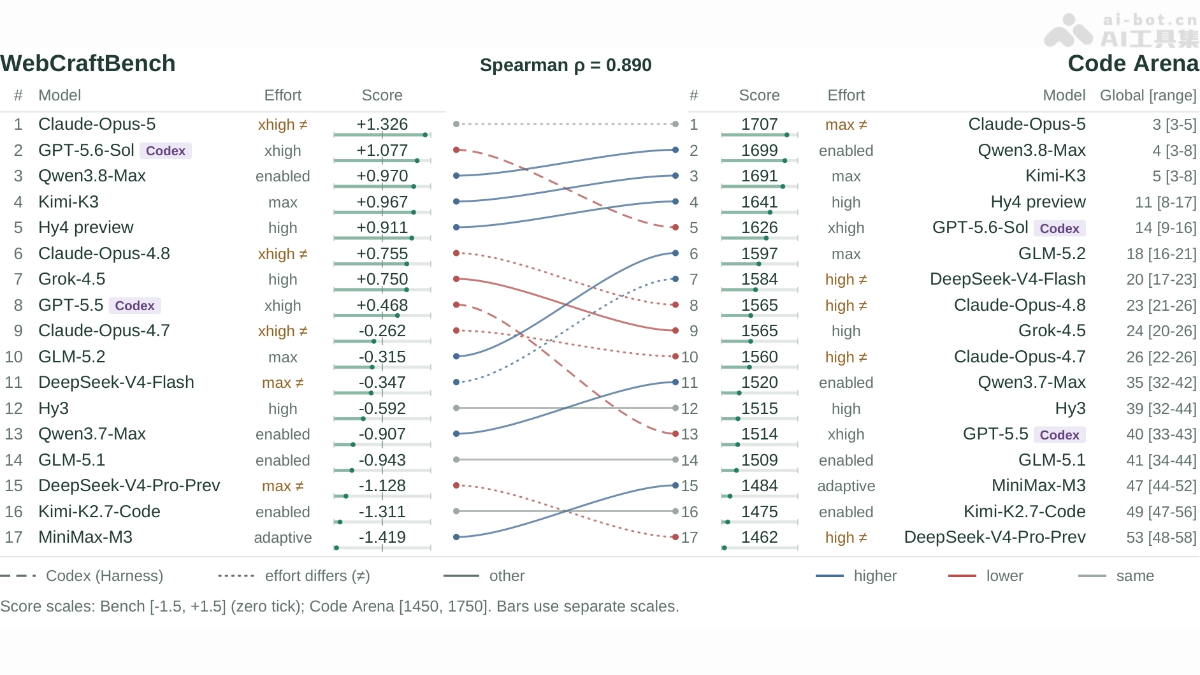
WebCraftBench ٹینسینٹ ہونگ یوان، سنگھوا یونیورسٹی اور پیکنگ یونیورسٹی کے اشتراک سے تیار کردہ AI ویب جنریشن کا جائزہ لینے کا معیار ہے۔ WebCraftBench پہلے تیار کردہ ایپلیکیشن میں خودکار انسٹرومنٹیشن شامل کرتا ہے، پھر ایجنٹ Playwright کے ذریعے ویب صفحے کو عملی طور پر استعمال کرتے ہوئے اس کی خصوصیات دریافت کرتا ہے اور کوڈ کوریج کے ذریعے نظر انداز شدہ حصوں کی نشاندہی کرتا ہے؛ اس کے بعد تعامل کے ریکارڈز کو اسٹیٹ گراف میں تبدیل کرکے خوب صورتی، استعمال میں آسانی اور تقاضوں سے مطابقت کے تین پہلوؤں پر الگ الگ اسکور دیتا ہے۔ اس معیار میں حقیقی تقاضوں کے 369 نمونے اور انسانی طور پر جانچے گئے 5,088 قبولیت کے معیارات شامل ہیں، جو 17 جدید ماڈلز کی 6,273 ایپلیکیشنز کا احاطہ کرتے ہیں، جبکہ انسانی ترجیحات سے مطابقت کی شرح 85.3% ہے۔
02WebCraftBench کی اہم خصوصیات
حقیقی تقاضوں کا جائزہ سیٹ: حقیقی استعمال کے ٹریفک سے حاصل کردہ صارفین کے 369 تقاضے شامل ہیں، جن کے ساتھ انسانی طور پر جانچے گئے 5,088 قبولیت کے معیارات ہیں، جو فعالیت، مواد اور بصری تقاضوں کی تین اقسام کا احاطہ کرتے ہیں۔
تعامل پر مبنی خودکار دریافت: ایجنٹ Playwright MCP کے ذریعے ٹیسٹر کی طرح کلک کرتا، معلومات درج کرتا اور صفحات تبدیل کرتا ہے، فعال طور پر خصوصیات دریافت کرتا اور حدودی حالات کو جانچتا ہے۔
کوڈ کوریج کی رہنمائی: Istanbul پر مبنی خودکار انسٹرومنٹیشن کے ذریعے کوریج کی حقیقی وقت میں نگرانی کی جاتی ہے؛ دریافت ناکافی ہونے پر معاون ماڈل ان کوڈ حصوں کی نشاندہی کرتا ہے جہاں ابھی رسائی نہیں ہوئی۔
اسٹیٹ کا تجرید اور تنظیم: طویل آپریشن ریکارڈز سے تکرار ختم کرکے انہیں معیاری بنایا جاتا ہے اور اسٹیٹ ٹرانزیشن گراف میں ضم کیا جاتا ہے، تاکہ اسکورنگ کے لیے اہم عملی شواہد اخذ کیے جا سکیں۔
تین آزاد جہتی اسکور: خوب صورتی، استعمال میں آسانی اور تقاضوں سے مطابقت کا الگ الگ جائزہ لے کر معیاری مجموعی اسکور تیار کیا جاتا ہے۔
انسانی ترجیحات کی توثیق: ایک آزاد توثیقی سیٹ پر نظرثانی شدہ انسانی ووٹنگ سے موازنہ کیا گیا؛ جوڑی کی بنیاد پر فیصلوں کی مطابقت 85.3% رہی، جس سے جائزے کی قابلِ اعتمادیت ثابت ہوتی ہے۔
03WebCraftBench کا تکنیکی اصول
خودکار انسٹرومنٹیشن کے ذریعے عملی شواہد جمع کرنا: نظام ایپلیکیشن کے کوڈ میں کاؤنٹرز شامل کرتا ہے اور static HTML، Vite، Next، CRA اور Astro سمیت مختلف فریم ورکس کو سپورٹ کرتا ہے۔ ایپلیکیشن شروع ہونے کے بعد ہر تعامل کوڈ کوریج اور اس کے اضافے کو واپس بھیجتا ہے، جس سے یہ قابلِ مشاہدہ ہو جاتا ہے کہ کون سا کوڈ چل چکا ہے۔
کوریج کی رہنمائی میں ایجنٹ کی دریافت: دریافت کرنے والا ایجنٹ سورس کوڈ یا قبولیت کی فہرست نہیں دیکھتا، بلکہ GUI ٹیسٹنگ کے عمل کے مطابق ویب صفحے کو استعمال کرتا ہے۔ جب مسلسل تین تعاملات سے کوریج میں کوئی اضافہ نہ ہو تو نظام دوسرے ماڈل سے ایسے کوڈ کا تجزیہ کرواتا ہے جو ابھی نہیں چلا، پھر تجاویز کو قدرتی زبان میں تبدیل کرکے دریافت کرنے والے ایجنٹ کو مزید کوشش کے لیے دیتا ہے۔
اسٹیٹ کا تجرید اور تعامل کے راستے کو مختصر کرنا: صفحے کے ڈھانچے کو معیاری بنایا جاتا ہے، ایک جیسے صفحات کو ایک ہی اسٹیٹ میں ضم کیا جاتا ہے اور آپریشنز کو اسٹیٹ ٹرانزیشن گراف سے جوڑا جاتا ہے۔ اس طرح بار بار آنے والے اسکرین شاٹس اسکورنگ ماڈل کے سیاق و سباق پر غیر ضروری بوجھ نہیں ڈالتے اور خرابی کے راستے واضح رہتے ہیں۔
دریافت اور اسکورنگ کو الگ رکھ کر کثیر جہتی اسکورنگ: دریافت کے مرحلے میں شواہد جمع کرتے وقت قبولیت کی فہرست نہیں دیکھی جاتی؛ اسکورنگ کے مرحلے میں ہی ہر معیار کے مطابق شواہد تلاش کیے جاتے ہیں۔ خوب صورتی اور استعمال میں آسانی کا جائزہ ”خوبیاں تلاش کریں—خامیاں نشان زد کریں—فیصلہ کرکے اسکور دیں“ کے تین مرحلوں میں لیا جاتا ہے؛ تقاضوں سے مطابقت کے لیے ہر فیصلے میں عملی شواہد کا حوالہ ضروری ہے اور اسکور تکمیل کے تناسب کے مطابق دیا جاتا ہے۔ تینوں پہلو مجموعی اسکور کا ایک ایک تہائی ہیں۔
04WebCraftBench کا استعمال کیسے کریں
تیار کردہ ایپلیکیشن تیار کریں: جانچے جانے والے ماڈل سے تقاضوں کے مطابق ویب ایپلیکیشن تیار کروائیں اور اسے قابلِ عمل حالت میں تعینات کریں۔
خودکار انسٹرومنٹیشن: WebCraftBench کا انسٹرومنٹیشن ٹول چلائیں اور ایپلیکیشن کے کوڈ میں کوریج کاؤنٹرز شامل کریں، تاکہ ہر تعامل کوڈ کے اجرا کی معلومات واپس بھیج سکے۔
تعامل پر مبنی دریافت: دریافت کرنے والے ایجنٹ کو شروع کریں، Playwright MCP کے ذریعے ویب صفحے کو استعمال کریں، کلک، معلومات درج کرنے اور صفحہ تبدیل کرنے جیسے اقدامات انجام دیں، اور فعال طور پر خصوصیات اور حدودی حالات کی جانچ کریں۔
کوریج کی رہنمائی میں کمی کی نشاندہی: جب مسلسل تین تعاملات میں کوریج میں کوئی اضافہ نہ ہو تو معاون ماڈل غیر فعال کوڈ کا تجزیہ کرکے قدرتی زبان میں تجاویز تیار کرتا ہے، جو دریافت کرنے والے ایجنٹ کو مزید دریافت کے لیے دی جاتی ہیں (زیادہ سے زیادہ 100 مراحل)۔
عملی شواہد کو منظم کریں: نظام صفحے کے ڈھانچے کا خودکار اسٹیٹ تجرید کرتا ہے، آپریشن ریکارڈز سے تکرار ختم کرکے انہیں اسٹیٹ ٹرانزیشن گراف میں ضم کرتا ہے، اور اسکرین شاٹس و تعامل کے راستے محفوظ رکھتا ہے۔
تین جہتی اسکورنگ: اسکورنگ ایجنٹ خوب صورتی اور استعمال میں آسانی کا الگ الگ جائزہ لیتا ہے، جبکہ تقاضوں سے مطابقت کے لیے قبولیت کے ہر معیار کے مطابق جانچ کرتا ہے؛ ہر فیصلے میں عملی شواہد کا حوالہ ضروری ہے۔
نتائج جاری کریں: تینوں پہلوؤں کے معیاری اسکور اور مجموعی اسکور حاصل کریں، جن کا ماڈل پول کی درجہ بندی سے موازنہ کیا جا سکتا ہے؛ اسکور کا فرق جتنا زیادہ ہو، نتیجہ اتنا ہی قابلِ اعتماد ہوتا ہے۔
05WebCraftBench کے بنیادی فوائد
حقیقی استعمال پر مبنی: ایجنٹ ویب صفحے کو حقیقی طور پر استعمال کرکے اسکور دیتا ہے، صرف کوڈ یا اسکرین شاٹ نہیں دیکھتا، اس لیے ”داخلے کا بٹن خراب ہے، ہوم پیج نہیں کھلتا“ جیسے مسائل بھی دریافت ہو جاتے ہیں جو جامد جائزوں سے رہ جاتے ہیں۔
کوریج کی رہنمائی میں دریافت: کوڈ کوریج کو کمی کی نشاندہی کے سراغ کے طور پر استعمال کیا جاتا ہے؛ جب ٹیسٹنگ ایجنٹ کو کوئی خصوصیت نہیں ملتی تو پسِ منظر کا ماڈل سمت بتاتا ہے، جس سے دریافت کی ناکامی کو غلطی سے مصنوعات کی خامی قرار دینے کا امکان کم ہوتا ہے۔
دریافت اور اسکورنگ کی علیحدگی: قبولیت کی فہرست صرف اسکورنگ کے مرحلے میں استعمال ہوتی ہے، اس طرح تقاضوں کی پابندیاں برقرار رہتی ہیں اور فہرست سے باہر کے تعاملات کے مشاہدے میں رکاوٹ نہیں آتی، جس سے جائزے کا دائرہ وسیع ہوتا ہے۔
کثیر جہتی آزاد اسکورنگ: خوب صورتی، استعمال میں آسانی اور تقاضوں سے مطابقت کو الگ الگ اسکور کیا جاتا ہے، تاکہ ”ظاہری طور پر خوب صورت مگر استعمال کرتے ہی ناکام“ ماڈل کی کمزوری کسی ایک مجموعی اسکور میں چھپ نہ جائے۔
انسانی ترجیحات سے بلند مطابقت: نظرثانی شدہ انسانی موازنے کے 197 گروپس میں فیصلوں کی مطابقت 85.3% رہی، جبکہ اسکور کا فرق بڑا ہونے پر (≥0.75) مطابقت 98% تک پہنچ گئی، اس لیے نتائج قابلِ اعتماد ہیں۔
جائزے کا مضبوط استحکام: اسکورنگ کے فیصلے کرنے والے ماڈل کو تبدیل کرنے کے بعد بھی درجہ بندی کا ارتباطی گتانک 0.980 رہا، پہلے چار مقامات کی ترتیب تبدیل نہیں ہوئی، اور نتائج کسی ایک فیصلے کرنے والے ماڈل پر منحصر نہیں رہے۔
06WebCraftBench کا منصوبے کا پتہ
arXiv تکنیکی مقالہ: https://arxiv.org/pdf/2609.15387
07WebCraftBench کے اطلاقی منظرنامے
AI پروگرامنگ ٹولز کے لیے ماڈل کا انتخاب: جب ٹیم یہ فیصلہ کرے کہ ویب ایپلیکیشن تیار کرنے کے لیے کون سا بڑا ماڈل استعمال کیا جائے، تو WebCraftBench کے تین جہتی اسکورز سے معروضی موازنہ کیا جا سکتا ہے، تاکہ صرف demo کی ظاہری خوب صورتی کی بنیاد پر فیصلہ نہ ہو۔
AI ویب جنریشن مصنوعات کی قبولیتی جانچ: WebCraftBench کے ”حقیقی استعمال پر مبنی عمل“ کو مصنوعات کی ترسیل کے مرحلے میں شامل کریں، صفحہ بہ صفحہ دستی جانچ کی جگہ خودکار طور پر غیر فعال داخلوں اور ناقابلِ رسائی خصوصیات جیسے مسائل دریافت کریں۔
کوڈ جنریشن ماڈلز کی تکراری رجعتی جانچ: ماڈل کے ہر اپ گریڈ کے بعد معیار کو دوبارہ چلائیں اور خوب صورتی، استعمال میں آسانی اور تقاضوں سے مطابقت میں ہونے والی تبدیلیوں کا موازنہ کریں، تاکہ مقداراً معلوم ہو سکے کہ نیا ورژن بہتر ہوا ہے یا کمزور۔
جنریشن کے معیار کی درجہ وار تشخیص: جہتی تقسیم اور کم کوریج کے اشاروں سے مسئلے کی وجہ معلوم کریں کہ ڈیزائن کمزور ہے، تعامل میں bug ہے یا تقاضوں کی سمجھ غلط ہے، اور اسی بنیاد پر ہدفی بہتری کی رہنمائی کریں۔
© دستبرداری: ڈومینز اور لنک شدہ مواد وقت کے ساتھ تبدیل ہو سکتے ہیں۔ AIEZZ فریقِ ثالث کی ویب سائٹس کو کنٹرول نہیں کرتا۔ بیرونی مواد اور خطرات کا آزادانہ جائزہ لیں۔
صارف کے جائزے0