
- ماہانہ وزٹس
- 0
- قیمتیں
- متعین نہیں
- فہرست میں شامل
- —
- اپ ڈیٹ شدہ
- 2026-09-28
01Kev کیا ہے؟
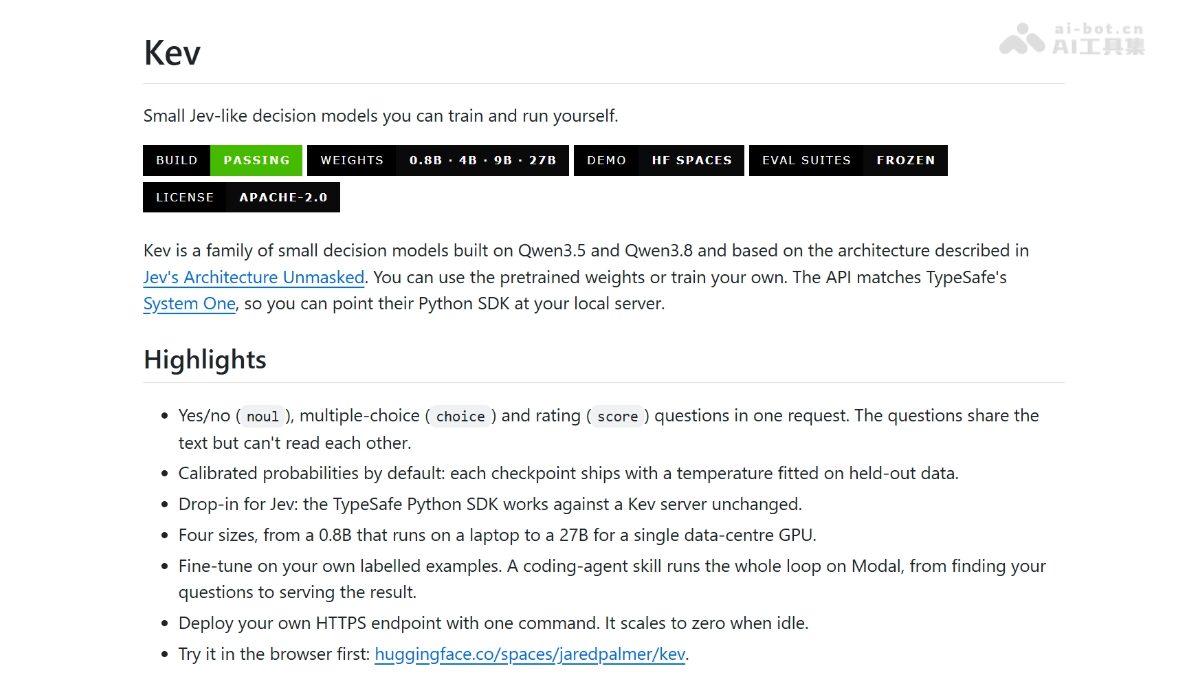
Kev، Cognition کے انجینئرنگ VP Jared Palmer کی جانب سے اوپن سورس کیا گیا فیصلہ سازی کے ماڈلز کا خاندان ہے، جو Qwen3.5/Qwen3.8 پر مبنی ہے اور 0.8B سے 27B تک مختلف ماڈلز فراہم کرتا ہے۔ Kev متن تیار نہیں کرتا؛ یہ اسٹیٹ ٹیکسٹ اور ساختی سوالات وصول کرتا ہے، اور ایک ہی فارورڈ پاس میں براہِ راست calibrated probabilities فراہم کرتا ہے۔ یہ ہاں/نہیں، آپشن روٹنگ اور درجہ بندی اسکورنگ پر مبنی تین اقسام کے فیصلوں کو سپورٹ کرتا ہے اور TypeSafe System One کے API کے ساتھ مطابقت رکھتا ہے۔
02Kev کے اہم افعال
ساختی فیصلہ سازی: اسٹیٹ ٹیکسٹ اور متعدد ساختی سوالات درج کریں؛ ایک ہی درخواست میں ہر آپشن کی calibrated probability براہِ راست حاصل کریں، اور یہ کبھی وضاحتی متن تیار نہیں کرتا۔
تین فیصلہ سازی کے primitives: noul، choice اور score کو سپورٹ کرتا ہے۔
بیچ سوالات کی علیحدگی: متعدد سوالات ایک ہی ان پٹ اسٹیٹ شیئر کرتے ہیں، مگر attention mask کے ذریعے ایک دوسرے سے الگ رہتے ہیں۔ ایک ہی فارورڈ پاس میں تمام سوالات کے جوابات ملتے ہیں اور کوئی سوال دوسرے کو متاثر نہیں کرتا۔
مقامی تعیناتی: kev.serve ایک کمانڈ سے سروس شروع کرتا ہے، POST /v1/systemone endpoint فراہم کرتا ہے، اور CUDA، ROCm اور Apple Silicon (MLX) کے ساتھ مطابقت رکھتا ہے۔
کم لاگت fine-tuning: اپنے لیبل شدہ ڈیٹا سے آفیشل checkpoint کی بنیاد پر مزید تربیت کی سہولت دیتا ہے۔ kev-finetune skill کے ذریعے coding agent ڈیٹا کی تیاری، تربیت، جائزہ اور تعیناتی کا مکمل عمل خودکار طور پر انجام دے سکتا ہے۔
بلٹ اِن جائزہ نظام: منجمد evaluation set کے ذریعے accuracy، Brier score، calibration error اور خودکار فیصلہ سازی کے تناسب کی رپورٹ تیار کرتا ہے، جبکہ CI ریلیز کے اعداد و شمار کی خودکار جانچ کرتا ہے۔
03Kev کیسے استعمال کریں
微信 پر فالو کرکے “开源” کا جواب دیں اور AI اوپن سورس پروجیکٹس کے گروپ میں شامل ہوں
pointer head نسل سازی کو امتیازی درجہ بندی میں تبدیل کرتا ہے: Kev، Qwen کے base weights کو منجمد رکھتا ہے اور rank-16 LoRA adapter اور pointer head منسلک کرتا ہے۔ ہر امیدوار کے hidden state اور سوال کے hidden state کو اسکور کیا جاتا ہے، پھر softmax کے ذریعے probability حاصل ہوتی ہے۔ بنیادی طور پر یہ بڑے ماڈل کے ”تحریری سوال“ کو ”کثیر الانتخاب سوال“ میں تبدیل کرتا ہے اور token-by-token generation کو چھوڑ دیتا ہے۔
block causal attention سوالات کو الگ رکھتی ہے: ان پٹ sequence کو ”اسٹیٹ + متعدد سوالی blocks“ کے طور پر منظم کیا جاتا ہے۔ attention mask ہر token کو صرف اسٹیٹ اور موجودہ سوال کے اندرونی حصے تک رسائی دیتا ہے، جبکہ position ID ہر سوال پر دوبارہ شمار ہوتی ہے۔ اس طرح ایک ہی فارورڈ پاس میں متعدد غیر متعلق سوالات کے جوابات دیے جا سکتے ہیں؛ اسٹیٹ کا حساب مشترک رہتا ہے اور معلومات ایک دوسرے تک نہیں پہنچتیں۔ Qwen3.5/3.8 جیسے hybrid Gated DeltaNet ماڈلز میں ہر سوال کو الگ row میں رکھا جاتا ہے اور اسٹیٹ کے KV cache کو دوبارہ استعمال کیا جاتا ہے، جس سے علیحدگی مزید سخت ہو جاتی ہے۔
تربیت اور calibration: درست labels پر cross-entropy کے ذریعے adapter اور pointer head کو train کیا جاتا ہے، جبکہ base model مکمل طور پر منجمد رہتا ہے۔ ہر checkpoint کے لیے holdout data پر temperature parameter fit کیا جاتا ہے۔ inference کے دوران calibrated probabilities براہِ راست حاصل ہوتی ہیں؛ temperature ترتیب کو تبدیل نہیں کرتا بلکہ confidence کی عددی قدر کو calibrate کرتا ہے۔
04Kev کیسے استعمال کریں
ماحول کی تیاری: Python 3.12/3.13 اور uv انسٹال کریں، repository clone کریں، پھر dependencies انسٹال کرنے کے لیے uv sync --extra serve چلائیں۔
مقامی سروس شروع کرنا: ماڈل شروع کرنے کے لیے KEV_DTYPE=bf16 uv run --extra serve python -m kev.serve --run jaredpalmer/kev-4b --port 8009 چلائیں؛ پہلی بار چلنے پر weights خودکار طور پر ڈاؤن لوڈ ہو جائیں گے۔
فیصلہ سازی کی درخواست بھیجنا: POST /v1/systemone پر state متن اور questions بھیجیں؛ جواب میں ہر آپشن کی calibrated probability حاصل ہوگی۔
Python SDK کال: TypeSafe کے آفیشل SDK میں base_url کو مقامی سروس کی طرف مقرر کریں؛ موجودہ Jev ایپ میں کسی تبدیلی کے بغیر منتقلی ممکن ہے۔
براؤزر میں آزمائش: Hugging Face Space یا مقامی playground کھولیں؛ انسٹالیشن کے بغیر تجربہ کریں۔
اپنے ڈیٹا پر fine-tuning: لیبل شدہ ڈیٹا کو JSONL format میں تیار کریں، پھر آفیشل checkpoint کی بنیاد پر مزید تربیت کے لیے uv run python -m kev.train --init_from jaredpalmer/kev-4b ... چلائیں۔
Agent کے ذریعے خودکار fine-tuning: npx skills add jaredpalmer/kev@kev-finetune چلانے کے بعد coding agent سے مسئلے تلاش کرنے، ڈیٹا بنانے، تربیت، جائزے اور تعیناتی کا مکمل عمل کروائیں؛ مقامی GPU درکار نہیں۔
کلاؤڈ تعیناتی: HTTPS endpoint کو ایک کمانڈ سے deploy کرنے کے لیے pip install modal && modal deploy kev_serve.py چلائیں؛ غیر فعال ہونے پر سروس خودکار طور پر صفر تک scale down ہو جاتی ہے اور اس دوران فیس نہیں لی جاتی۔
جائزہ اور تصدیق: منجمد evaluation set پر نتائج جانچنے کے لیے uv run python -m kev.benchmark --run <ماڈل> --suite evals/v4/transfer-v4 استعمال کریں؛ پہلے جائزہ لیں، پھر پروڈکشن میں جاری کریں۔
05Kev کے بنیادی فوائد
انتہائی کم لاگت: ایک ہی فارورڈ پاس میں probabilities براہِ راست حاصل ہوتی ہیں، token-by-token generation کی ضرورت نہیں رہتی۔ H100 پر 6 سوالات کے جواب صرف 18ms میں ملتے ہیں، اور خود میزبانی کے بعد فی کال کوئی لاگت نہیں۔
سستی اور قابلِ تکرار تربیت: آفیشل تین ماڈلز کی منتقلی پر تقریباً 95 امریکی ڈالر خرچ ہوئے، جبکہ ذاتی fine-tuning تقریباً 1 امریکی ڈالر میں کی جا سکتی ہے۔ مکمل بل شفاف طور پر دستیاب ہے۔
اوپن سورس اور قابلِ کنٹرول: Apache-2.0 لائسنس کے تحت weights، training code اور منجمد evaluation set سب عوامی ہیں؛ آپ خود تربیت کر سکتے ہیں، audit کر سکتے ہیں اور vendor lock-in سے بچ سکتے ہیں۔
Plug-and-play API: TypeSafe System One کے ساتھ مکمل مطابقت؛ موجودہ Jev ایپ میں صرف base_url تبدیل کرکے بغیر کسی اور تبدیلی کے منتقلی ممکن ہے۔
ایک بار میں متعدد سوالات: مشترک ان پٹ اسٹیٹ اور block causal attention کی علیحدگی کے ذریعے ایک ہی فارورڈ پاس میں کسی بھی تعداد کے سوالات کے جوابات دیے جاتے ہیں، بغیر باہمی آلودگی کے۔
06Kev کا پروجیکٹ لنک
GitHub repository: https://github.com/jaredpalmer/kev
07Kev کے استعمال کے منظرنامے
کسٹمر سروس ٹکٹ روٹنگ: ایک ہی فارورڈ پاس میں بیک وقت فیصلہ کریں کہ ”کس شعبے کو بھیجنا ہے، انسانی نمائندے تک بڑھانا ہے یا نہیں، اور گاہک کے غصے کی سطح کیا ہے“۔ probability threshold کے مطابق خودکار تقسیم کریں، جبکہ کم confidence والے معاملات انسانی نمائندے کو بھیجیں۔
مواد کی سلامتی کا جائزہ: UGC متن پر بیک وقت ”noul کیا خلاف ورزی ہے + choice خلاف ورزی کی قسم + score شدت“ چلائیں، اور زیادہ confidence والے معاملات پر خودکار کارروائی کریں۔
مالیات/کریڈٹ کی ابتدائی جانچ: شکایت کی قسم، انسانی مداخلت کی ضرورت اور خطرے کی سطح کا تعین کریں۔ probability distribution تعمیری ریکارڈ اور انسانی جائزے کی ترجیح طے کرنے میں مدد دے گی۔
ای کامرس پروڈکٹ/ارادے کی درجہ بندی: صارف کے سوالات کو search، recommendation یا after-sales جیسے downstream systems تک بھیجیں، اور ”ایک لفظ کے متعدد categories سے تعلق“ والی multi-label distribution کے مسئلے کو سنبھالیں۔
© دستبرداری: ڈومینز اور لنک شدہ مواد وقت کے ساتھ تبدیل ہو سکتے ہیں۔ AIEZZ فریقِ ثالث کی ویب سائٹس کو کنٹرول نہیں کرتا۔ بیرونی مواد اور خطرات کا آزادانہ جائزہ لیں۔
صارف کے جائزے0