
- ماہانہ وزٹس
- 0
- قیمتیں
- متعین نہیں
- فہرست میں شامل
- —
- اپ ڈیٹ شدہ
- 2026-09-10
01AuK کیا ہے؟
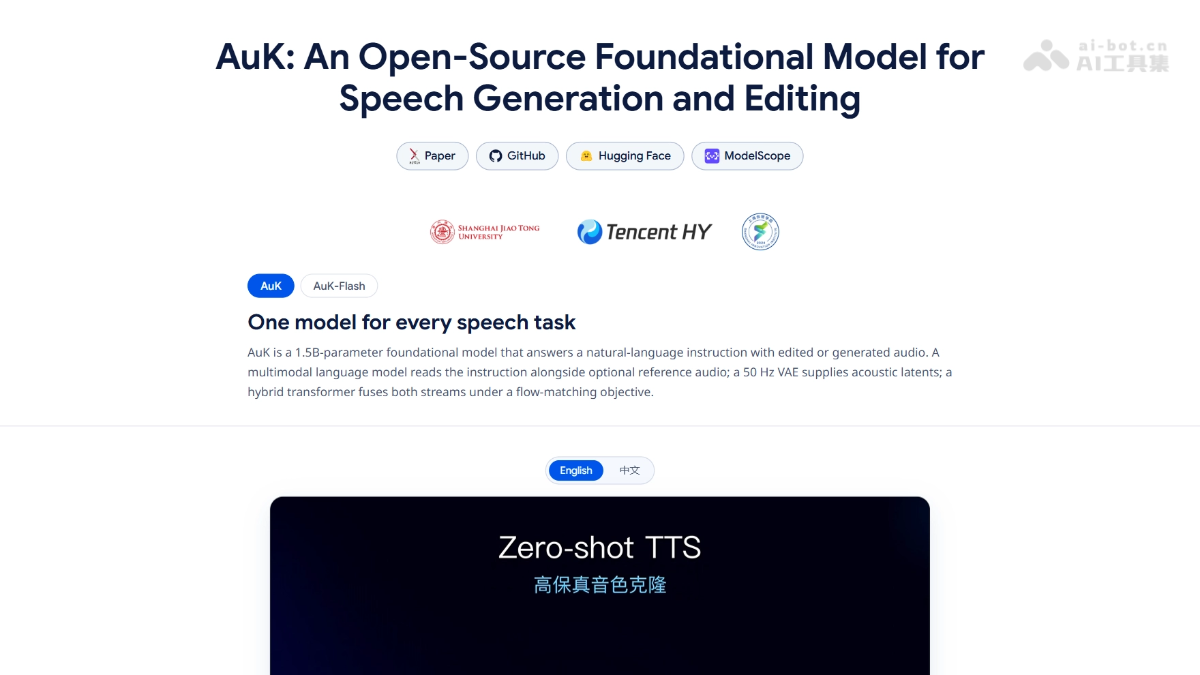
AuK، Tencent Hunyuan کا اوپن سورس کردہ 1.5 ارب پیرامیٹرز پر مشتمل آواز کی تخلیق اور تدوین کا بنیادی ماڈل ہے، جو آٹو ریگریسو کے بجائے فلو میچنگ ڈفیوژن آرکیٹیکچر استعمال کرتا ہے۔ ماڈل ایک متحد قدرتی زبان کی ہدایتی انٹرفیس کے ذریعے آواز سے متعلق 16 کام انجام دے سکتا ہے، جن میں زیرو شاٹ/ہدایتی TTS، صوتی مواد کی تدوین، صوتی خصوصیات کی ایڈجسٹمنٹ، غیر لسانی صوتی عناصر کی تدوین، شور میں کمی اور انسانی آواز کی علیحدگی شامل ہیں۔ ماڈل 4 مراحل کی推理 والا AuK-Flash تیز ورژن بھی فراہم کرتا ہے، جس کی رفتار تقریباً 4.5 گنا زیادہ ہے۔
02AuK کی اہم خصوصیات
Zero-shot TTS: چند سیکنڈ کی حوالہ جاتی آڈیو سے آواز کی خصوصیات نقل کرکے نئی آواز تیار کریں۔
Instruct TTS: آواز کی خصوصیات کو صرف تحریری وضاحت کے ذریعے بیان کریں اور حوالہ جاتی آڈیو کے بغیر متعلقہ آواز تیار کریں۔
صوتی مواد کی تدوین: آواز کی خصوصیات اور لہجے کو برقرار رکھتے ہوئے ریکارڈنگ میں موجود الفاظ کو تبدیل، شامل یا حذف کریں۔
گیت کے بولوں کی تدوین: دھن اور گائیکی کی خصوصیات برقرار رکھتے ہوئے صرف بول تبدیل کریں۔
پچ/رفتار/حجم کی تدوین: صوتی خصوصیات کو سیمی ٹون، رفتار کے گنا اور ڈیسی بل کی اکائیوں میں درست طور پر ایڈجسٹ کریں۔
جذبات اور آواز کی تدوین: الفاظ تبدیل کیے بغیر جذباتی رنگ بدلیں، یا مواد برقرار رکھتے ہوئے آواز کی خصوصیات تبدیل کریں۔
لہجے کی تدوین اور شور میں کمی: لہجہ دور کریں، شور اور گونج کم کریں، اور وضاحت بہتر بنائیں۔
غیر لسانی صوتی واقعات کی تدوین: سانس لینے کی آواز، ہنسی اور کھانسی شامل یا حذف کریں، اور عام تقریر کو سرگوشی میں یا اس کے برعکس تبدیل کریں۔
آواز کی علیحدگی: متعدد افراد کی آڈیو کو بولنے کی ترتیب کے مطابق الگ کریں، یا مواد کی وضاحت کے مطابق مطلوبہ مقرر کی آواز نکالیں۔
موسیقی کی علیحدگی: گانے سے انسانی آواز نکالیں اور ساز کو حذف کریں۔
03AuK کا تکنیکی اصول
WeChat پر فالو کرکے “开源” کا جواب دیں اور AI اوپن سورس منصوبوں کے گروپ میں شامل ہوں۔
مجموعی طریقۂ کار: AuK آڈیو کی پوشیدہ اسپیس کی نمائندگی تخلیق کرنے کے لیے فلو میچنگ ڈفیوژن آرکیٹیکچر استعمال کرتا ہے، جو تدوین سے متعلق کاموں کے لیے فطری طور پر موزوں ہے۔ یہ اصل آڈیو کی پوشیدہ نمائندگی کو ڈی نوائزنگ کے نقطۂ آغاز کے طور پر استعمال کرتا ہے اور صرف ہدایت کے مطابق مطلوبہ حصے میں تبدیلی کرتا ہے، جس سے اصل آواز، دھن اور غیر تدوین شدہ مواد زیادہ بہتر طور پر محفوظ رہتا ہے۔ یہی خصوصیت اسے تدوین سے متعلق کاموں کے پورے مجموعے کو سنبھالنے کی تکنیکی بنیاد فراہم کرتی ہے۔
تین اجزائی پائپ لائن: نظام تین حصوں پر مشتمل ہے: ملٹی موڈل بڑا ماڈل قدرتی زبان کی ہدایات اور حوالہ جاتی آڈیو پڑھ کر معنوی شرائط تیار کرتا ہے؛ آڈیو VAE، 24kHz波形 کو 50Hz کی صوتی پوشیدہ اسپیس میں انکوڈ کرتا ہے؛ بنیادی ہائبرڈ Transformer، 10 تہوں والے ڈوئل اسٹریم MMDiT اور 20 تہوں والے سنگل اسٹریم DiT پر مشتمل ہے۔ ماڈل کی چوڑائی 1536 اور کل پیرامیٹرز 1.5 ارب ہیں۔
بڑے پیمانے پر ہدایتی ہم آہنگی کی تربیت: تربیتی ڈیٹا میں تقریباً 3.03 ارب “ہدایت—آڈیو” جوڑے شامل ہیں، جبکہ مؤثر نگرانی کا مجموعی دورانیہ تقریباً 1.95 ملین گھنٹے ہے۔ اہم بات یہ ہے کہ تمام کاموں کو ایک ہی فارمیٹ، یعنی “ہدایت + ان پٹ آڈیو → آؤٹ پٹ آڈیو”، میں متحد کیا گیا ہے، جس سے ماڈل ایک ہی انٹرفیس کے ذریعے 16 کاموں تک عمومی صلاحیت حاصل کرتا ہے۔
بعد از تربیت اور انسانی ترجیحات کی اصلاح: بنیادی تربیت کے بعد ماڈل کو انسانی ترجیحات کی اصلاح اور تقویتی سیکھنے پر مبنی بعد از تربیت (RL post-training) سے گزارا جاتا ہے، جس سے تیار کردہ آواز کی فطری روانی، ہدایات پر عمل اور سماعتی معیار بہتر ہوتا ہے۔
04AuK استعمال کرنے کا طریقہ
ہارڈویئر ماحول کی تصدیق کریں: تقریباً 24GB ویڈیو میموری والا NVIDIA GPU تیار کریں، مثلاً RTX 3090/4090۔
کوڈ ریپوزٹری کلون کریں: GitHub سے Tencent-Hunyuan/AuK ریپوزٹری مقامی ماحول میں کلون کریں۔
انحصاری ماحول انسٹال کریں: ریپوزٹری کی ضروریات کے مطابق Python ماحول ترتیب دیں اور مطلوبہ پیکیجز انسٹال کریں۔
ماڈل کے وزن ڈاؤن لوڈ کریں: Hugging Face یا ModelScope سے AuK کے وزن اور متعلقہ VAE فائلیں ڈاؤن لوڈ کریں۔
معنوی شرطوں والا ماڈل ڈاؤن لوڈ کریں: ہدایات اور حوالہ جاتی آڈیو کی تشریح کے لیے ملٹی موڈل بڑے ماڈل Qwen2.5-Omni-3B کو الگ سے ڈاؤن لوڈ اور ترتیب دیں۔
ان پٹ مواد تیار کریں: مطلوبہ متن، حوالہ جاتی آڈیو یا تدوین کے لیے اصل آڈیو فائل تیار رکھیں۔
قدرتی زبان کی ہدایات لکھیں: کام کی ضرورت کے مطابق ہدایات تحریر کریں، مثلاً آواز کی خصوصیات بیان کرنا، تبدیل کیے جانے والے جملے کی نشاندہی کرنا، یا پچ/رفتار کو ایڈجسٹ کرنا۔
推理 چلائیں: کمانڈ لائن (CLI) کے ذریعے ہدایات اور مواد داخل کریں، تخلیق یا تدوین شروع کریں اور آؤٹ پٹ کا انتظار کریں۔
سن کر ایڈجسٹ کریں: نتیجے کی آڈیو چیک کریں؛ اگر تسلی بخش نہ ہو تو ہدایات کے الفاظ، سیمپلنگ کے مراحل یا CFG کی شدت تبدیل کرکے دوبارہ تخلیق کریں۔
05AuK کے بنیادی فوائد
متحد انٹرفیس، کاموں کی مکمل کوریج: ماڈل قدرتی زبان کی ہدایات کے ذریعے TTS، تدوین، بہتری اور علیحدگی سمیت 16 صوتی کام انجام دے سکتا ہے، اور ہر کام کے لیے الگ ماڈل تعینات کرنے کی ضرورت نہیں۔
تدوین کی صلاحیت نایاب ہے: الفاظ تبدیل کرنے، جملے شامل کرنے، پچ ایڈجسٹ کرنے اور جذبات بدلنے جیسی باریک تدوین کی معاونت کرتا ہے، جبکہ اصل آواز اور لہجے کو زیادہ سے زیادہ برقرار رکھتا ہے۔
Instruct TTS میں حوالہ جاتی آڈیو کی ضرورت نہیں: آواز کی خصوصیات کی تحریری وضاحت سے آواز تیار کی جا سکتی ہے، جس سے استعمال آسان ہو جاتا ہے۔
فلو میچنگ آرکیٹیکچر زیادہ اصل پن فراہم کرتا ہے: ٹوکن بہ ٹوکن پیش گوئی کے بجائے ڈفیوژن پر مبنی تخلیق استعمال ہوتی ہے؛ تدوین کے دوران اصل آڈیو سے ڈی نوائزنگ شروع ہونے کے باعث غیر تبدیل شدہ حصوں کو تقریباً کوئی نقصان نہیں پہنچتا۔
06AuK منصوبے کا پتہ
منصوبے کی ویب سائٹ: https://auk-project.github.io/
GitHub ریپوزٹری: https://github.com/Tencent-Hunyuan/AuK
HuggingFace ماڈل ریپوزٹری: https://huggingface.co/tencent/AuK
arXiv تکنیکی مقالہ: https://arxiv.org/pdf/2609.08936
07AuK کے استعمال کے مواقع
فلم، ٹی وی اور مختصر ڈراموں میں بعد از پروڈکشن مکالموں کی اصلاح: اداکار کے غلط لفظ بولنے یا اسکرپٹ میں معمولی تبدیلی کی صورت میں ریکارڈنگ کے مخصوص الفاظ یا جملے براہِ راست تبدیل کریں، دوبارہ اسٹوڈیو میں ڈبنگ کی ضرورت نہیں رہتی اور اصل اداکاری کے جذبات محفوظ رہتے ہیں۔
پوڈکاسٹ اور انٹرویو کی تیاری: زبان کی لغزشیں اور غیر ضروری گفتگو حذف کریں، بولنے کی رفتار اور ردھم ایڈجسٹ کریں، پس منظر کا شور اور گونج دور کریں، اور خام مواد کو ایک مرحلے میں مکمل پروگرام میں تبدیل کریں۔
آڈیو بکس اور AI ڈبنگ کی تیاری: Instruct TTS کے ذریعے کردار کی وضاحت کے مطابق مختلف آوازیں تیار کریں؛ ایک ہی narrator بعد ازاں جذبات اور لہجہ بھی ایڈجسٹ کر سکتا ہے، جس سے متعدد کرداروں کی تیاری کی لاگت کم ہوتی ہے۔
موسیقی کی تخلیق اور تخلیقی دوبارہ استعمال: اصل دھن اور گائیکی کی خصوصیات برقرار رکھتے ہوئے گیت کے بول تبدیل کریں، یا گانے سے انسانی آواز نکال کر remix کے مواد کے طور پر استعمال کریں۔
زبان کی تربیت اور قابلِ رسائی ایپلی کیشنز: لہجے یا زبان کی دشواری رکھنے والے صارفین کے لیے لہجہ دور کریں، رفتار اور حجم ایڈجسٹ کریں، اور زیادہ واضح و آسانی سے سمجھ آنے والا صوتی مواد تیار کریں۔
© دستبرداری: ڈومینز اور لنک شدہ مواد وقت کے ساتھ تبدیل ہو سکتے ہیں۔ AIEZZ فریقِ ثالث کی ویب سائٹس کو کنٹرول نہیں کرتا۔ بیرونی مواد اور خطرات کا آزادانہ جائزہ لیں۔
صارف کے جائزے0