
- Oylik tashriflar
- 0
- Narxlar
- Belgilanmagan
- Ro‘yxatga kiritilgan
- —
- Yangilangan
- 2026-09-24
01Qwen-Audio-3.1 nima
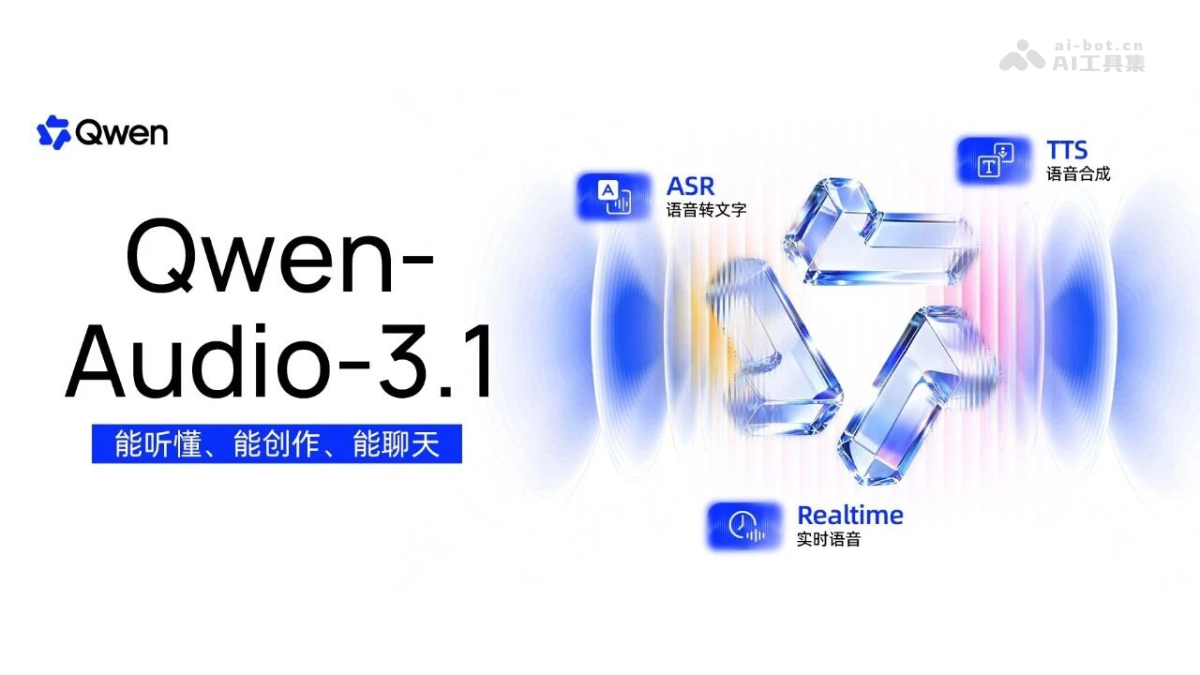
Qwen-Audio-3.1 — Tongyi Qianwen tomonidan ishlab chiqilgan nutq uchun katta modellar seriyasi bo‘lib, beshta modelni o‘z ichiga oladi: ASR nutqni tanish, ASR-Next audioni tushunish, TTS nutq sintezi, TTS-Next audio yaratish va Realtime real vaqt rejimidagi o‘zaro aloqa. U tushunish–yaratish–o‘zaro aloqa–ijodning to‘liq zanjirini qamrab oladi. Qwen-Audio-3.1 30 ta til va 16 ta xitoy lahjasini, so‘zlovchilar bo‘yicha transkripsiyani, hissiyotlarni anglashni hamda to‘liq dupleksli real vaqt suhbatini qo‘llab-quvvatlaydi va vazifalarni bajarish uchun vositalarni chaqira oladi.
02Qwen-Audio-3.1 ning asosiy funksiyalari
ASR nutqni tanish: 30 ta til va 16 ta xitoy lahjasida so‘zlovchilar bo‘yicha transkripsiyani qo‘llab-quvvatlaydi, so‘zlovchi teglari va vaqt belgilarini qo‘shadi hamda matnni bevosita tahrirlay oladi.
ASR-Next audioni tushunish: transkripsiya matnidan tashqari, inson hissiyotlari, atrof-muhit va mexanik tovushlarni ham tushunadi; tovushni tavsiflash, hodisani aniqlash va audio savol-javobni qo‘llab-quvvatlaydi.
TTS nutq sintezi: ko‘p tilli va ko‘p lahjali sintezni qo‘llab-quvvatlaydi, bir xil ovoz tembrini turli tillarga tabiiy ko‘chiradi hamda ko‘rsatmalar orqali hissiyot va nutq tezligini boshqaradi.
TTS-Next audio yaratish: inson ovozi, ovoz effektlari va atrof-muhit tovushlaridan iborat to‘liq audioni bir martada yaratadi; podkast, audiokitob, kino, o‘yin va reklama uchun mos.
Realtime real vaqt rejimidagi o‘zaro aloqa: bir vaqtning o‘zida tinglash va gapirishni, hissiyot va maqsadni tushunishni, tillar o‘rtasida almashishni qo‘llab-quvvatlaydi hamda suhbat davomida vazifalarni bajarish uchun vositalarni chaqira oladi.
03Qwen-Audio-3.1 ning texnik tamoyillari
Uchidan-uchiga birgalikda modellashtirish (ASR): Qwen-Audio-3.1-ASR uchidan-uchiga yondashuvdan foydalanib, so‘zlovchi teglari, vaqt belgilari va transkripsiya matnini birgalikda chiqaradi. Bu an’anaviy ketma-ket tizimlardagi bosqichma-bosqich ishlovdan farq qiladi va shu sababli qisqa qo‘shilib ketgan replikalar hamda ustma-ust tushadigan nutqni saqlab qoladi. Model shuningdek, keraksiz og‘zaki to‘ldiruvchilarni olib tashlash, takrorlarni bartaraf etish, o‘zini tuzatish va semantik qayta tuzish imkoniyatlariga ega bo‘lib, transkripsiya natijasini uchrashuv bayonnomalari va suhbat tahlili uchun bevosita ishlatish mumkin bo‘lgan shaklga keltiradi.
Keyingi avlod audio tushunish arxitekturasi (ASR-Next): ASR-Next keyingi avlod arxitekturasiga asoslanadi va ishlov beriladigan obyektni “nutqdagi matn”dan to‘liq audio signaligacha kengaytiradi. Akustik darajadagi hissiyotlar, atrof-muhit va mexanik tovushlarni tushunish orqali tovush hodisalarini aniqlash, tavsiflash va ular bo‘yicha xulosa chiqarishni amalga oshiradi. Bu ASRning transkripsiya vositasidan universal audio tushunish modeligacha rivojlanganini anglatadi.
Ovoz tembrini ko‘chirish va ifodani boshqarish (TTS): TTS modeli faqat talaffuzning to‘g‘riligiga intiladigan an’anaviy sintez usulidan o‘tib, bir xil ovoz tembrini turli tillar va lahjalarga tabiiy ko‘chirishni ta’minlaydi. Ko‘rsatmalar orqali hissiyot, nutq tezligi va ifoda usulini modellashtirib, sintez qilingan nutqni mazmun va vaziyatga moslashtiradi.
Yagona audio yaratish (TTS-Next): TTS-Next matn, vaqt belgilari va namunaviy audio kabi uch turdagi kirish ma’lumotlari asosida inson ovozi, ovoz effektlari va atrof-muhit tovushlarini yagona jarayonda yaratadi. Ko‘p bosqichli suhbatlarda turli rollarning ovoz tembri va hissiyotlari izchilligini saqlaydi, tabiiy til orqali yaratish jarayonini boshqaradi, mayda aniqlikdagi vaqt belgilarini boshqarish, ovozni nusxalash va 48kHz yuqori aniqlikdagi chiqarishni qo‘llab-quvvatlaydi.
Ko‘p o‘qituvchili distillyatsiyaga asoslangan to‘liq dupleksli arxitektura (Realtime): Realtime ko‘p o‘qituvchili distillyatsiya arxitekturasidan foydalanib, past kechikishni saqlagan holda tushunish, xulosa chiqarish, ifodalash va xavfsizlik imkoniyatlarini yaxshilaydi. U to‘liq dupleksli o‘zaro aloqani, bir vaqtning o‘zida gapirish va tinglashni hamda istalgan paytda suhbatga aralashib, gapni bo‘lishni qo‘llab-quvvatlaydi. Model vositalarni chaqirish imkoniyatini birlashtirib, uzluksiz suhbat davomida o‘zgaruvchan ehtiyojlarni tushunadi va vazifalarni bajarish uchun tashqi API, bilim bazalari hamda biznes tizimlariga ulanadi.
04Qwen-Audio-3.1 dan qanday foydalanish kerak
Qianwen AI platformasini oching: https://www.qianwenai.com/ manziliga kiring, hisobingizga kiring va modellar maydoniga o‘ting.
Kerakli modelni tanlang: ehtiyojingizga qarab mos modelni tanlang: ASR (transkripsiya), TTS (sintez), TTS-Next (ijod) yoki Realtime (real vaqt rejimidagi o‘zaro aloqa), so‘ng tafsilotlar sahifasiga o‘ting.
API Key oling: boshqaruv panelida model xizmatini yoqing va interfeys autentifikatsiyasi uchun API Key yarating.
Interfeysni chaqiring: har bir model tafsilotlari sahifasidagi API hujjatlariga amal qilib, HTTP so‘rovi orqali audio yoki matn parametrlarini yuboring (ASR-Next API hali ishga tushirilmagan, ochilishini kutish kerak).
Ilovaga integratsiya qiling: interfeysni o‘z ilovangiz, Agent yoki aqlli qurilmangizga ulang va nutqqa oid vazifalarni onlayn bajaring.
05Qwen-Audio-3.1 ning asosiy afzalliklari
Kuchli ko‘p tilli va lahjali imkoniyatlar: bitta model 30 ta til va 16 ta xitoy lahjasini qo‘llab-quvvatlaydi; Venchjou lahjasi kabi tushunish qiyin lahjalarni tanish ayniqsa sezilarli yaxshilangan.
Transkripsiyani aqlli tahrirlash: ASR keraksiz og‘zaki to‘ldiruvchilarni olib tashlash, takrorlarni bartaraf etish va semantik qayta tuzishni bevosita amalga oshiradi, natijada ravonroq, mantiqiyroq va tuzilgan matn hosil bo‘ladi.
So‘zlovchilar bo‘yicha yuqori aniqlikdagi transkripsiya: uchidan-uchiga so‘zlovchi teglari, vaqt belgilari va matnni chiqaradi hamda Fun-ASR ketma-ket tizimidan har tomonlama ustun.
Audioni tushunishning yangi bosqichi: ASR-Next hissiyotlar, atrof-muhit va mexanik tovushlarni tushunadi, “transkripsiya matni”dan “to‘liq audioni tushunish”ga ko‘tariladi.
Yaratish imkoniyatlarining birlashuvi: TTS-Next inson ovozi, ovoz effektlari va atrof-muhit tovushlarini bir martada yaratadi; turli rollarning ovoz tembri va hissiyotlari izchil bo‘lib, bir nechta mutaxassislar ishtirokidagi post-ishlov jarayonining o‘rnini bosadi.
Inson darajasidagi real vaqt o‘zaro aloqasi: to‘liq dupleksli tinglash va gapirish, suhbatni bo‘lish imkoniyati, hissiyotlarni anglash va vazifalarni bajarish uchun vositalarni chaqirishni qo‘llab-quvvatlaydi.
Past kechikish va yuqori unumdorlik: oqimli tanishda birinchi belgi javobi taxminan 160 millisekundni tashkil etadi; Realtime ko‘p o‘qituvchili distillyatsiya asosida past kechikish va xulosa chiqarish qobiliyatini uyg‘unlashtiradi.
06Qwen-Audio-3.1 loyihasi manzili
Onlayn demo: Qwen-Audio-3.1-ASR: https://www.qianwenai.com/models/qwen-audio-3.1-asr-flash
Qwen-Audio-3.1-TTS: https://www.qianwenai.com/models/qwen-audio-3.1-tts-flash
Qwen-Audio-3.1-TTS-Next: https://www.qianwenai.com/models/qwen-audio-3.1-tts-next
Qwen-Audio-3.1-Realtime: https://www.qianwenai.com/models/qwen-audio-3.1-realtime-plus
07Qwen-Audio-3.1 ning qo‘llanilish sohalari
Uchrashuv bayonnomalari va intervyu yozuvlari: ASRning so‘zlovchilar bo‘yicha transkripsiyasi va vaqt belgilari funksiyalari yordamida “kim, qachon, nima dedi” mazmunidagi tuzilgan yozuvlarni avtomatik yaratadi, og‘zaki nutqdagi ortiqcha elementlarni tabiiy ravishda olib tashlaydi va uchrashuv samaradorligini sezilarli oshiradi.
Podkast va audiokitob yaratish: TTS-Next yordamida bir nechta ishtirokchi dialoglari, ovoz effektlari va atrof-muhit tovushlaridan iborat to‘liq audioni bir martada yarating; turli rollarning ovoz tembri va hissiyotlari izchil saqlanadi, boshlovchi, ovoz effektlari mutaxassisi va miksing muhandisi o‘rtasidagi mehnat taqsimotiga ehtiyoj kamayadi.
Real vaqt rejimidagi ovozli mijozlarga xizmat ko‘rsatish va aqlli yordamchi: Realtime’ning to‘liq dupleksli o‘zaro aloqasi va hissiyotlarni anglash imkoniyatlari asosida suhbatni bo‘lish mumkin bo‘lgan, hamdard ovozli xizmatni yarating; suhbat davomida so‘rov yuborish, buyurtma berish kabi vazifalarni bajarish uchun biznes tizimlarini ham chaqira oladi.
Xalqaro sayohat va ko‘p tilli muloqot: 30 ta til o‘rtasida real vaqt rejimida almashish va bir xil ovoz tembrini turli tillarda sintez qilish imkoniyatlaridan foydalanib, sayohatni rejalashtirish, transchegaraviy elektron tijorat va xalqaro uchrashuvlar uchun tabiiy hamda ravon ovozli tarjima va muloqot tajribasini taqdim etadi.
AI aqlli qurilmalari: QwenNote, Qianwen AI ko‘zoynagi kabi qurilmalar bilan birgalikda foydalanuvchi kompyuter yoki telefonni ochmasdan, bevosita ovoz orqali vazifalarni boshlashi, shartlarni qo‘shishi va bajarilishini kuzatishi mumkin. Shu tariqa ovoz AI qurilmalarining tabiiy interfeysiga aylanadi.
© Ogohlantirish: domenlar va havola qilingan kontent vaqt o‘tishi bilan o‘zgarishi mumkin. AIEZZ uchinchi tomon veb-saytlarini nazorat qilmaydi. Tashqi kontent va xatarlarni mustaqil ravishda ko‘rib chiqing.
Foydalanuvchi sharhlari0