
- Oylik tashriflar
- 0
- Narxlar
- Belgilanmagan
- Ro‘yxatga kiritilgan
- —
- Yangilangan
- 2026-09-14
01Xiaomi-CocktailASR-1 nima?
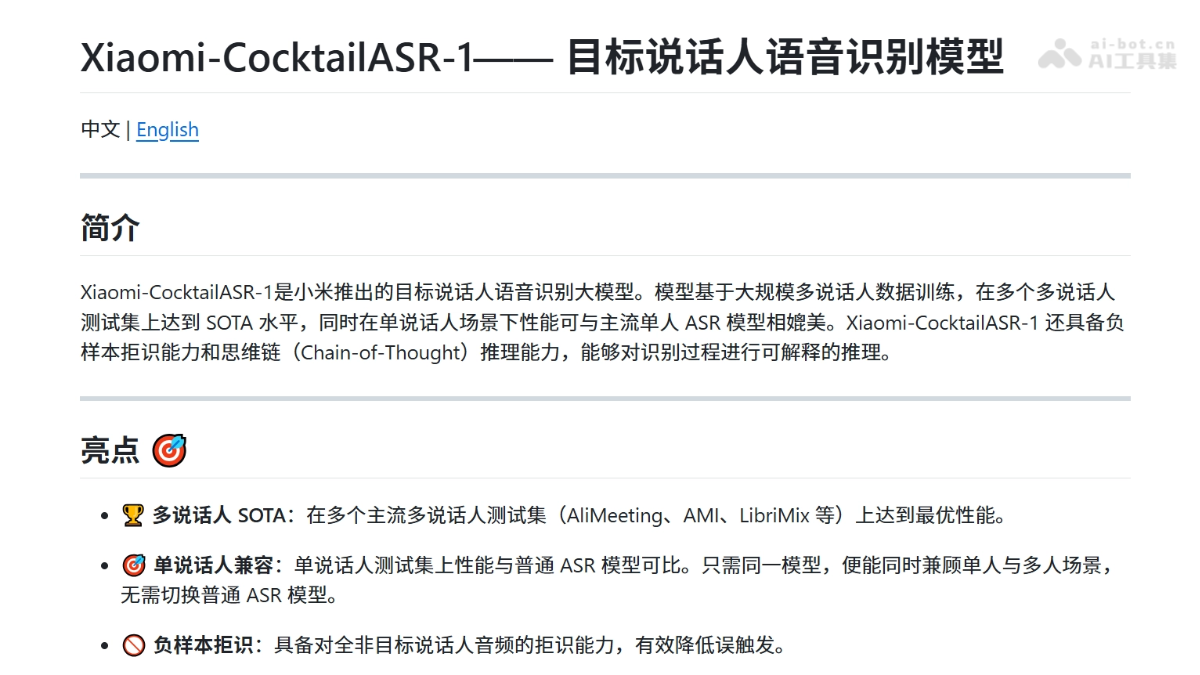
Xiaomi-CocktailASR-1 — Xiaomi tomonidan ochiq manba sifatida taqdim etilgan, maqsadli so‘zlovchini tanib nutqni matnga aylantiruvchi yirik model. U LLM asosidagi end-to-end arxitekturaga ega bo‘lib, referens audiodan ovoz izi ko‘rsatkichi sifatida foydalanadi va nutqni ajratmasdan, bir nechta so‘zlovchi aralashgan audiodan maqsadli so‘zlovchi nutqini aniq transkripsiya qiladi. Model bir nechta so‘zlovchili benchmarklarda SOTA darajasiga erishadi, shu bilan birga bitta so‘zlovchili holatlarni ham qo‘llab-quvvatlaydi. U manfiy namunalarni rad etish va fikrlash zanjiri orqali izohlanadigan xulosa chiqarish imkoniyatlariga ega hamda Apache 2.0 litsenziyasi asosida ochiq manbaga chiqarilgan.
02Xiaomi-CocktailASR-1 ning asosiy funksiyalari
Maqsadli so‘zlovchi nutqini tanish: referens audio va bir nechta so‘zlovchi aralashgan audio berilganda, nutqni ajratmasdan maqsadli so‘zlovchi mazmunini bevosita transkripsiya qiladi.
Bitta so‘zlovchini qo‘llab-quvvatlash: ayni model bitta so‘zlovchili holatlarni ham qayta ishlaydi, yetakchi bitta so‘zlovchili ASR tizimlariga yaqin natija beradi va model almashtirishni talab qilmaydi.
Manfiy namunalarni rad etish: maqsadli so‘zlovchi audioda bo‘lmaganda bo‘sh matn chiqaradi va noto‘g‘ri ishga tushishlarni samarali kamaytiradi.
Fikrlash zanjiri orqali xulosa chiqarish: CoT rejimida so‘zlovchilar soni, jinsi, ovoz izi o‘xshashligi kabi xulosa chiqarish jarayonlarini chiqaradi, bu esa izohlanish va tanish aniqligini uyg‘unlashtiradi.
03Xiaomi-CocktailASR-1 ning texnik prinsipi
End-to-end yagona arxitektura: model uch qismdan iborat: Data2Vec2 asosida takomillashtirilgan 0.6B audio kodlagich, yengil chiziqli Adapter va Qwen3-8B katta til modeli yadrosi. Kirish «referens audio + 1 soniya sukunat + aralash audio» tartibida birlashtiriladi. Kodlagich kadr darajasidagi xususiyatlarni chiqargach, Adapter ularni LLM yashirin fazosiga moslashtiradi va matnli Prompt bilan birga LLM ga yuborib, maqsadli so‘zlovchi transkripsiyasini hosil qiladi.
Referens audio shartli ko‘rsatma sifatida: kodlagich Data2Vec2 ning o‘z-o‘zini nazorat qiluvchi niqoblangan bashorat mexanizmidan foydalanib, bitta tarmoq ichida semantik va so‘zlovchi ma’lumotlarini birlashtiradi; alohida ovoz izi kodlagichi kerak emas. Referens audio shartli Prompt sifatida qaraladi, shu sababli kodlagich xususiyatlarni ajratish bosqichidayoq maqsadli so‘zlovchiga moslashib, xalaqit beruvchi nutqni bostiradi va an’anaviy «ajratish + tanish» zanjirli tizimlaridagi xatolar yig‘ilishini boshidan bartaraf etadi.
Ko‘p qobiliyatlarni muvozanatlashtiruvchi ko‘p bosqichli ta’lim: qariyb bir million soatlik ma’lumotlar nisbati orqali to‘rtta qobiliyat yagona modelda o‘rgatiladi: qariyb 400 ming soatlik bir nechta so‘zlovchili ma’lumotlar maqsadli nutqni ajratishga, qariyb 600 ming soatlik bir xil so‘zlovchining referens-maqsad juftliklari bitta holatga ortiqcha moslashishni oldini olishga, qariyb 10 ming soatlik mos kelmaydigan referensli manfiy namunalar rad etish qobiliyatini ichkilashtirishga xizmat qiladi, bunda xulosa chiqarish uchun chegara qiymati kerak emas. Bundan tashqari, CoT ma’lumotlari modelga avval fikrlash zanjirini, so‘ng javobni chiqarishni o‘rgatadi.
Ikki rejimli Prompt va rad etish mexanizmi: standart rejim bitta so‘zlovchini tanish, bir nechta so‘zlovchi orasidan maqsadlisini tanish va manfiy namunalarni rad etish kabi uch turdagi vazifani yagona Prompt bilan qamrab oladi. Maqsadli so‘zlovchi mavjud bo‘lmaganda model tabiiy ravishda bo‘sh matn chiqaradi. CoT rejimi esa alohida Prompt orqali fikrlash yorliqlarini ishga tushiradi, so‘zlovchilar soni, jinsi va ovoz izi o‘xshashligi kabi oraliq bosqichlarni chiqargach, yakuniy transkripsiyani beradi. Bu izohlanishni yaxshilaydi va WER ni biroz kamaytiradi.
04Xiaomi-CocktailASR-1 dan qanday foydalaniladi
Bog‘liqliklarni o‘rnatish: zarur muhitni o‘rnatish uchun pip install torch torchaudio transformers soundfile buyrug‘ini bajaring.
Modelni yuklab olish: model og‘irlik fayllarini HuggingFace (Ease3/Xiaomi-CocktailASR-1) dan yuklab oling.
Modelni yuklash: modelni AutoModel.from_pretrained("Ease3/Xiaomi-CocktailASR-1", trust_remote_code=True, torch_dtype="bfloat16").cuda().eval() orqali yuklang.
Audioni tayyorlash: 16k, mono formatdagi referens so‘zlovchi audiosi va tanilishi kerak bo‘lgan bitta yoki bir nechta so‘zlovchili audio tayyorlang (16k bo‘lmagan audio avtomatik qayta namunalashtiriladi).
Bitta namunani xulosa qilish: model("target.wav", "ref_speaker.wav") ni chaqirish orqali maqsadli so‘zlovchi transkripsiyasi qaytariladi (manfiy namunada bo‘sh matn avtomatik chiqariladi, qo‘shimcha parametr kerak emas).
Fikrlash zanjiri orqali xulosa chiqarish: cot=True parametrini qo‘shing; model ichida fikrlash jarayonini, ichida esa yakuniy natijani chiqaradi.
Ommaviy xulosa chiqarish: ma’lumotlarni 5 ustunli TSV (utt_id, wav, text, ref_wav, ref_id) ko‘rinishida tayyorlang, so‘ng tools/test_batch_scp.py ni model yo‘li, kirish TSV fayli va chiqish faylini ko‘rsatgan holda ishga tushiring.
05Xiaomi-CocktailASR-1 ning asosiy afzalliklari
Bir nechta so‘zlovchili holatlarda SOTA natijalar: AliMeeting, AMI, LibriMix kabi yetakchi bir nechta so‘zlovchili benchmarklarda eng yuqori tanish darajasiga erishadi (masalan, AliMeeting Far WER 20.63%, avvalgi SOTA 27.5% edi).
Bitta va bir nechta so‘zlovchili holatlarning yagona modeli: ayni model bitta so‘zlovchili holatlarda yetakchi ASR tizimlariga yaqin natija beradi va so‘zlovchilar soniga qarab model almashtirishni talab qilmaydi.
Manfiy namunalarni rad etish qobiliyati: maqsadli so‘zlovchi mavjud bo‘lmaganda bo‘sh matn chiqaradi, rad etish darajasi 68%-80% ga yetadi, Qwen3-ASR va StepAudio kabi modellarda esa bu ko‘rsatkich 0.
Fikrlash zanjiri orqali izohlanadigan xulosa: CoT rejimi so‘zlovchilar soni, jinsi va ovoz izi o‘xshashligi kabi xulosa chiqarish jarayonlarini chiqaradi, bu izohlanishni yaxshilaydi va WER ni biroz kamaytiradi.
Sodda end-to-end arxitektura: referens audio bevosita ovoz izi Prompti sifatida ishlatiladi, an’anaviy nutqni ajratish moduli kerak bo‘lmaydi va zanjirli tizimlardagi xatolar yig‘ilishini oldini oladi.
Foydalanish oson: bir qator kod orqali chaqiriladi, avtomatik qayta namunalashtirish va ommaviy xulosa chiqarishni qo‘llab-quvvatlaydi, ijobiy va manfiy namunalar Demo sini taqdim etadi, o‘rnatilgandan keyin darhol foydalanish mumkin.
06Xiaomi-CocktailASR-1 loyihasi manzillari
GitHub repozitoriysi:https://github.com/xiaomi-research/xiaomi-cocktailasr-1
HuggingFace model repozitoriysi:https://huggingface.co/Ease3/Xiaomi-CocktailASR-1
arXiv texnik maqolasi:https://arxiv.org/pdf/2609.11274
07Xiaomi-CocktailASR-1 ning qo‘llanish sohalari
Aqlli yig‘ilishlarda yo‘naltirilgan transkripsiya: ko‘p kishilik yig‘ilishlarda faqat belgilangan so‘zlovchi nutqini tinglab, boshqa ishtirokchilarning qo‘shimcha gaplari va muhokamalarini avtomatik filtrlash.
Ovozli yordamchida qurilma egasining buyruqlarini tanish: telefon, karnay va avtomobil tizimlarida faqat qurilma egasining ovoziga javob berish, fondagi inson ovozlari buyruqni noto‘g‘ri ishga tushirmasligi.
Mijozlarga xizmat ko‘rsatish va sifat nazorati yozuvlarini tahlil qilish: ko‘p kishilik qo‘ng‘iroq yozuvlaridan belgilangan tomonning to‘liq nutqini aniq ajratib olish, muvofiqlik nazorati va xizmatni baholashda foydalanish.
Aqlli uyda ovozli boshqaruv: televizor shovqini va ko‘p kishilik suhbatlar mavjud uy sharoitida pultni ushlab turgan insonning ovozli buyruqlarini aniq tanish va noto‘g‘ri amallarning oldini olish.
To‘siqsiz eshitish va qayd etish qurilmalari: eshitishida nuqsoni bo‘lgan shaxslar yoki qayd yozuvini yurituvchilar uchun muayyan so‘zlovchi nutqini yo‘naltirilgan tarzda ajratib, real vaqt rejimida matnga aylantirish; shovqinli ijtimoiy vaziyatlarda kerakli insonni «aniq eshitish»ga e’tibor qaratish.
© Ogohlantirish: domenlar va havola qilingan kontent vaqt o‘tishi bilan o‘zgarishi mumkin. AIEZZ uchinchi tomon veb-saytlarini nazorat qilmaydi. Tashqi kontent va xatarlarni mustaqil ravishda ko‘rib chiqing.
Foydalanuvchi sharhlari0