
Đánh giá mô hình
Thẻ công cụ AIEZZ
Đang xem các sản phẩm AI được gắn thẻ “Đánh giá mô hình”, với 5 kết quả phù hợp.
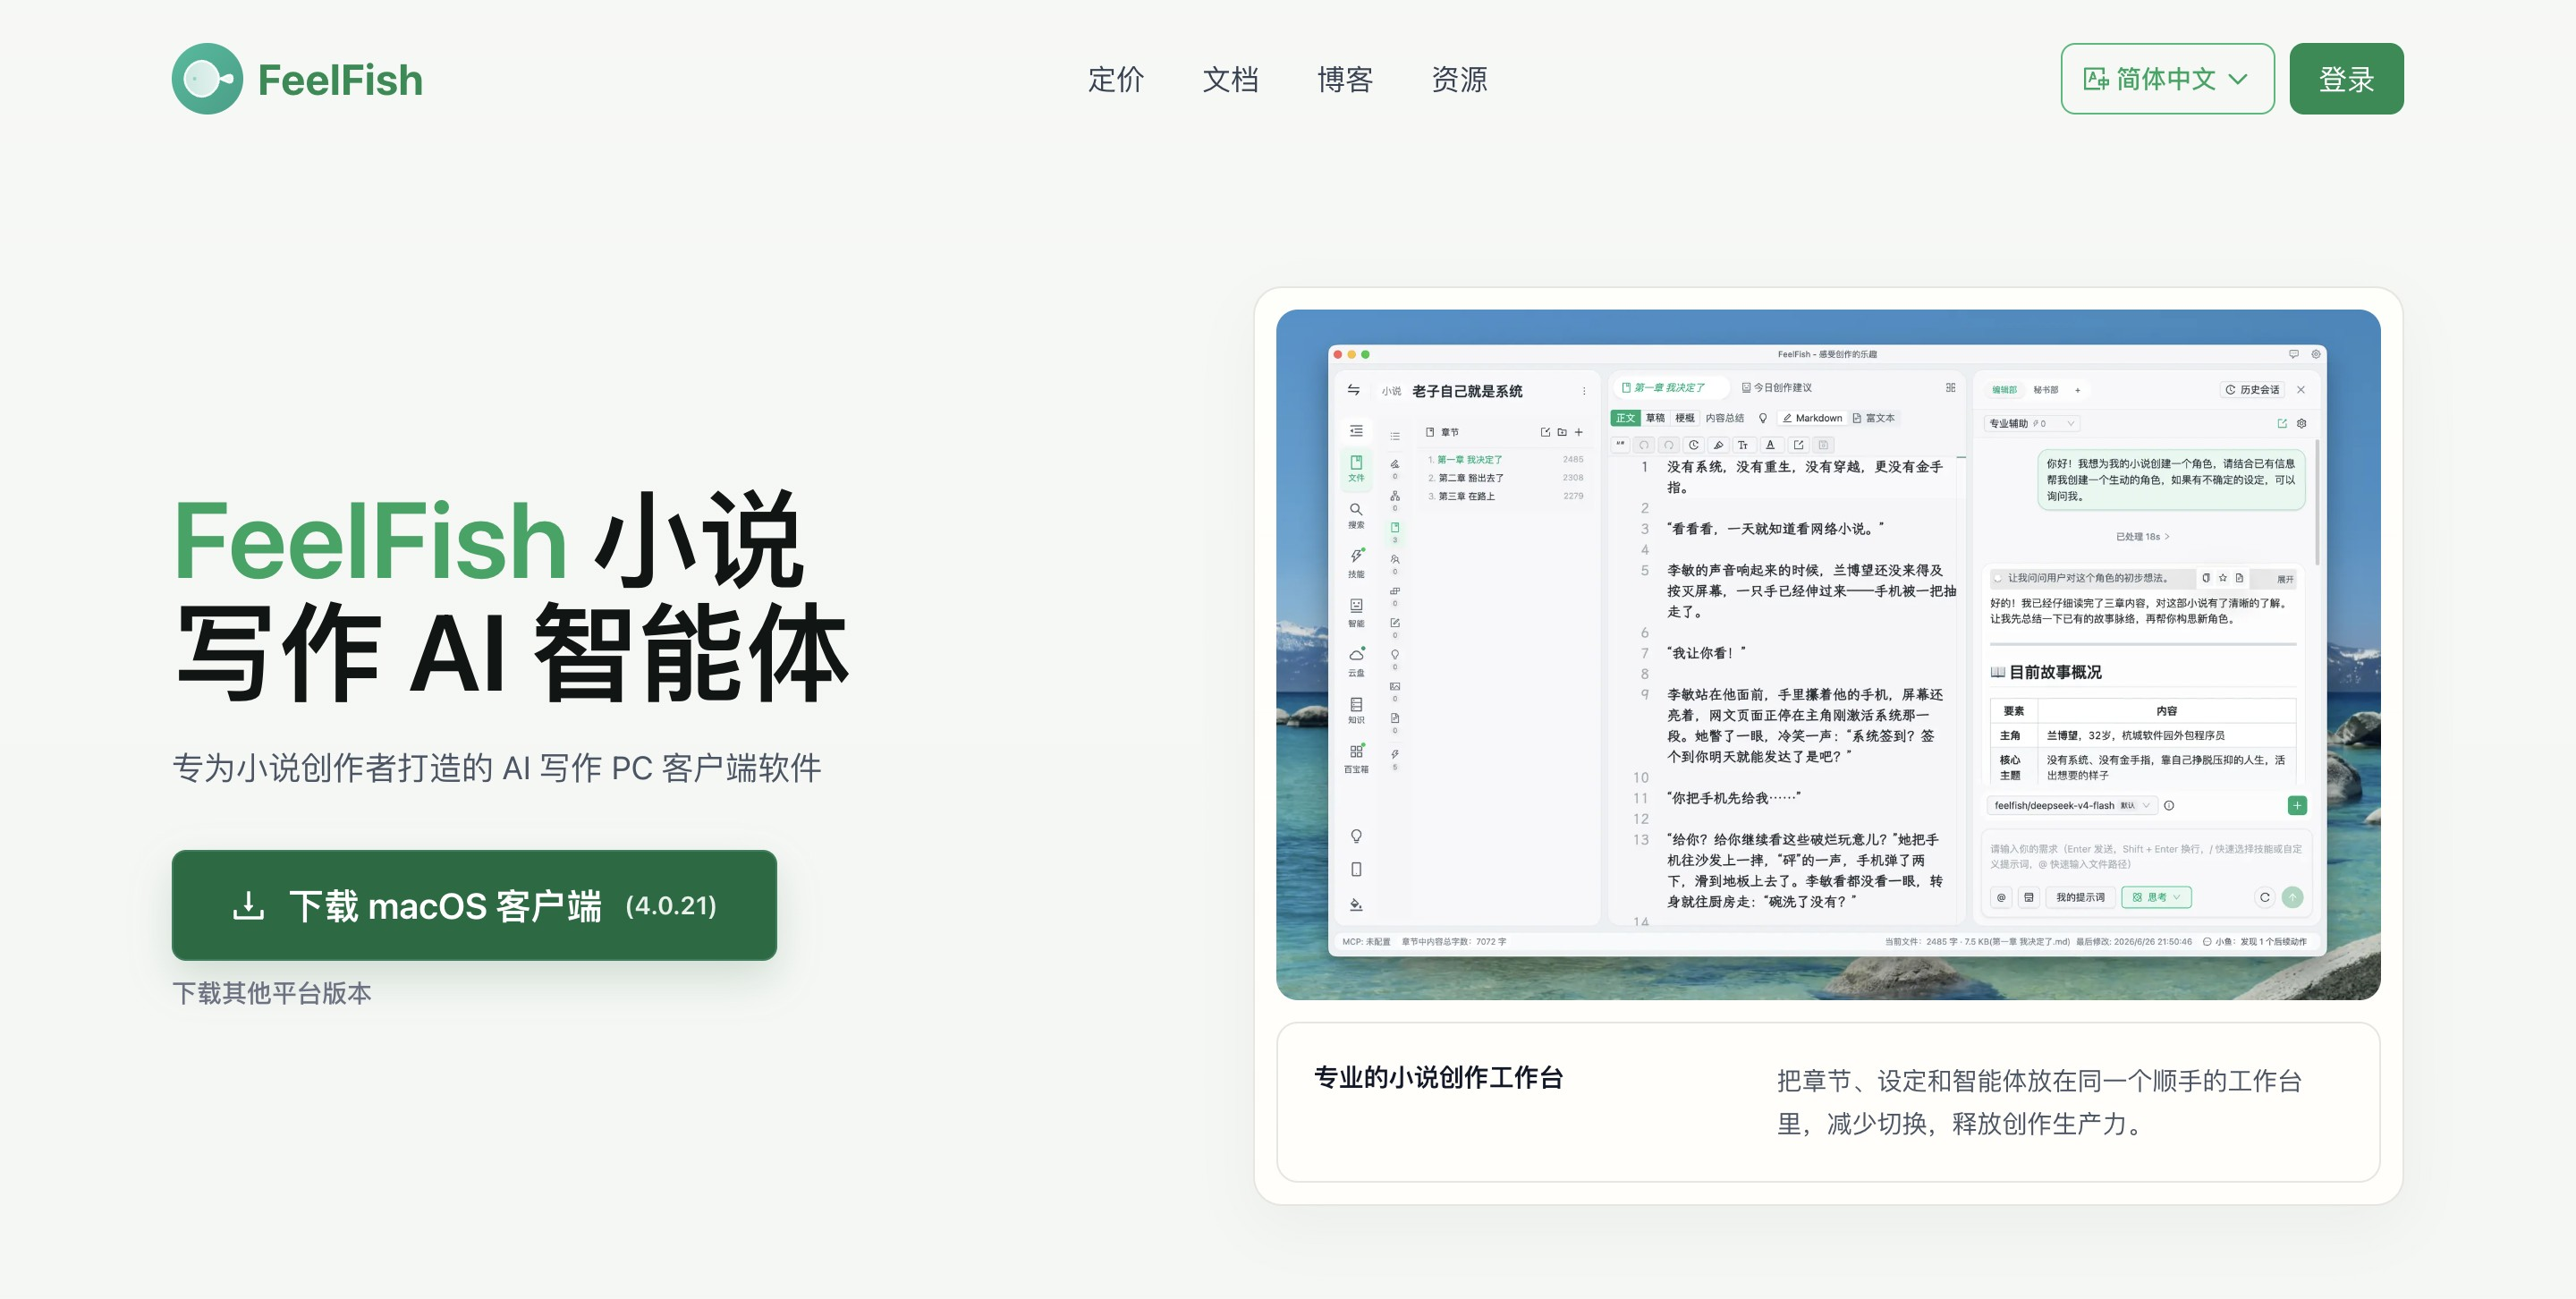 Đánh giá phần mềm viết tiểu thuyết AI mới nhất năm 2026: FeelFish 4.0Lập trình AIFeelFish 4.0 là phần mềm viết tiểu thuyết chuyên nghiệp, biến các mô hình AI quy mô lớn thành một đội ngũ viết lách am hiểu dự án. Phần mềm cung cấp khả năng quản lý dự án có cấu trúc, bao gồm chương, dàn ý, nhân vật và thiết lập, đồng thời hỗ trợ ngữ cảnh thông minh để duy trì tính nhất quán logic trong quá trình sáng tác tác phẩm dài. Công cụ này hỗ trợ cộng tác đa tác nhân tùy chỉnh, điều khiển từ xa trên máy tính và điện thoại, cùng đồng bộ đám mây và cỗ máy thời gian cục bộ để bảo đảm an toàn bản thảo, hướng đến việc cung cấp quy trình cộng tác hoàn chỉnh giữa người và AI cho tác giả tiểu thuyết mạng, kịch bản và các tác phẩm dài khác.00
 LMArenaBộ công cụ AILMArena là nền tảng đánh giá mô hình trí tuệ nhân tạo do một nhóm học thuật tại Đại học California, Berkeley dẫn dắt và vận hành dựa trên cộng đồng. Quy trình cốt lõi là cho hai mô hình ẩn danh trả lời cùng một câu hỏi, sau đó người dùng bình chọn dựa trên chất lượng câu trả lời và xem danh tính mô hình sau khi bình chọn. Dựa trên kết quả bình chọn và cơ chế tính điểm Elo tương tự cờ vua, nền tảng tạo bảng xếp hạng động, đồng thời hỗ trợ các tác vụ văn bản, hình ảnh và nhiều dạng khác. Nền tảng phù hợp với các nhà nghiên cứu AI, nhà phát triển, người yêu công nghệ và người dùng phổ thông muốn so sánh nhiều mô hình. Nền tảng cũng cung cấp bộ dữ liệu mở cho mục đích nghiên cứu. Cần lưu ý rằng bảng xếp hạng phản ánh sở thích của người dùng thực tế và hiệu suất trong từng tác vụ cụ thể, không thể thay thế các bài kiểm thử riêng về nhu cầu nghiệp vụ, chi phí hoặc độ ổn định.048
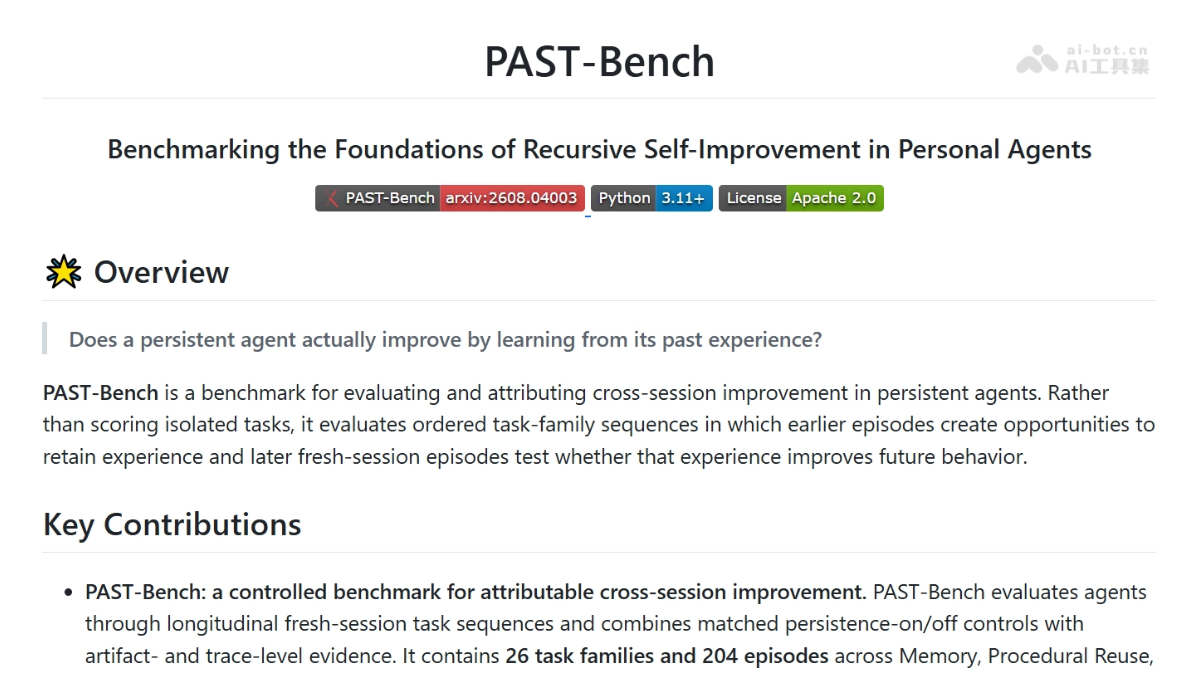 PAST-BenchTác nhân AIPAST-Bench là bộ tiêu chuẩn do nhóm của Wang Mengdi tại Đại học Princeton phát triển, dùng để đánh giá khả năng tự cải thiện đệ quy của các AI Agent cá nhân. PAST-Bench đánh giá bằng cách so sánh hiệu suất nhiệm vụ trong điều kiện có và không có bộ nhớ, xác định liệu kinh nghiệm liên phiên mà Agent lưu lại có thực sự cải thiện hành vi về sau hay không...00
 E-Bench – Bộ chuẩn đánh giá tác tử thông minh do Tencent Hunyuan và các bên phát triểnĐánh giá mô hình AIE-Bench là bộ chuẩn đánh giá khả năng sử dụng công cụ qua nhiều bước do nhóm Tencent Hunyuan phối hợp với AIR thuộc Đại học Thanh Hoa và Đại học Đông Nam phát triển. Bộ chuẩn xây dựng môi trường ảo tổng hợp hoàn toàn dựa trên Vương Giả Vinh Diệu, QQ Music và Tencent Meeting, bao gồm 323 tác vụ thay đổi trạng thái và hơn 7.6 vạn dòng dữ liệu. Thông qua thiết kế bất đối xứng kép giữa khoảng trống thông tin và khoảng trống công cụ, E-Bench đánh giá khả năng tác tử chủ động thu thập thông tin và điều phối các lệnh gọi công cụ qua nhiều bước. Kết quả được chấm bằng phép diff trạng thái cơ sở dữ liệu mang tính xác định, ổn định và có thể tái lập. Bộ chuẩn hướng đến các nhà nghiên cứu tác tử AI và nhà phát triển mô hình, hỗ trợ nhận diện những mô hình có hiệu quả chi phí cao và thúc đẩy việc xây dựng tiêu chuẩn đánh giá tác tử tổng quát.00
 Gemini 3.7 FlashLập trình AIGemini 3.7 Flash là mô hình AI chủ lực thế hệ mới do Google DeepMind phát triển. Mô hình được thiết kế chuyên biệt cho quy trình Coding và Agent, đạt bước tiến lớn trong các tiêu chuẩn về kỹ thuật phần mềm, phát triển web và tự động hóa doanh nghiệp...00
Tất cả công cụ có thẻ này được hiển thị.