
Mô hình ngôn ngữ lớn
Thẻ công cụ AIEZZ
Đang xem các sản phẩm AI được gắn thẻ “Mô hình ngôn ngữ lớn”, với 10 kết quả phù hợp.
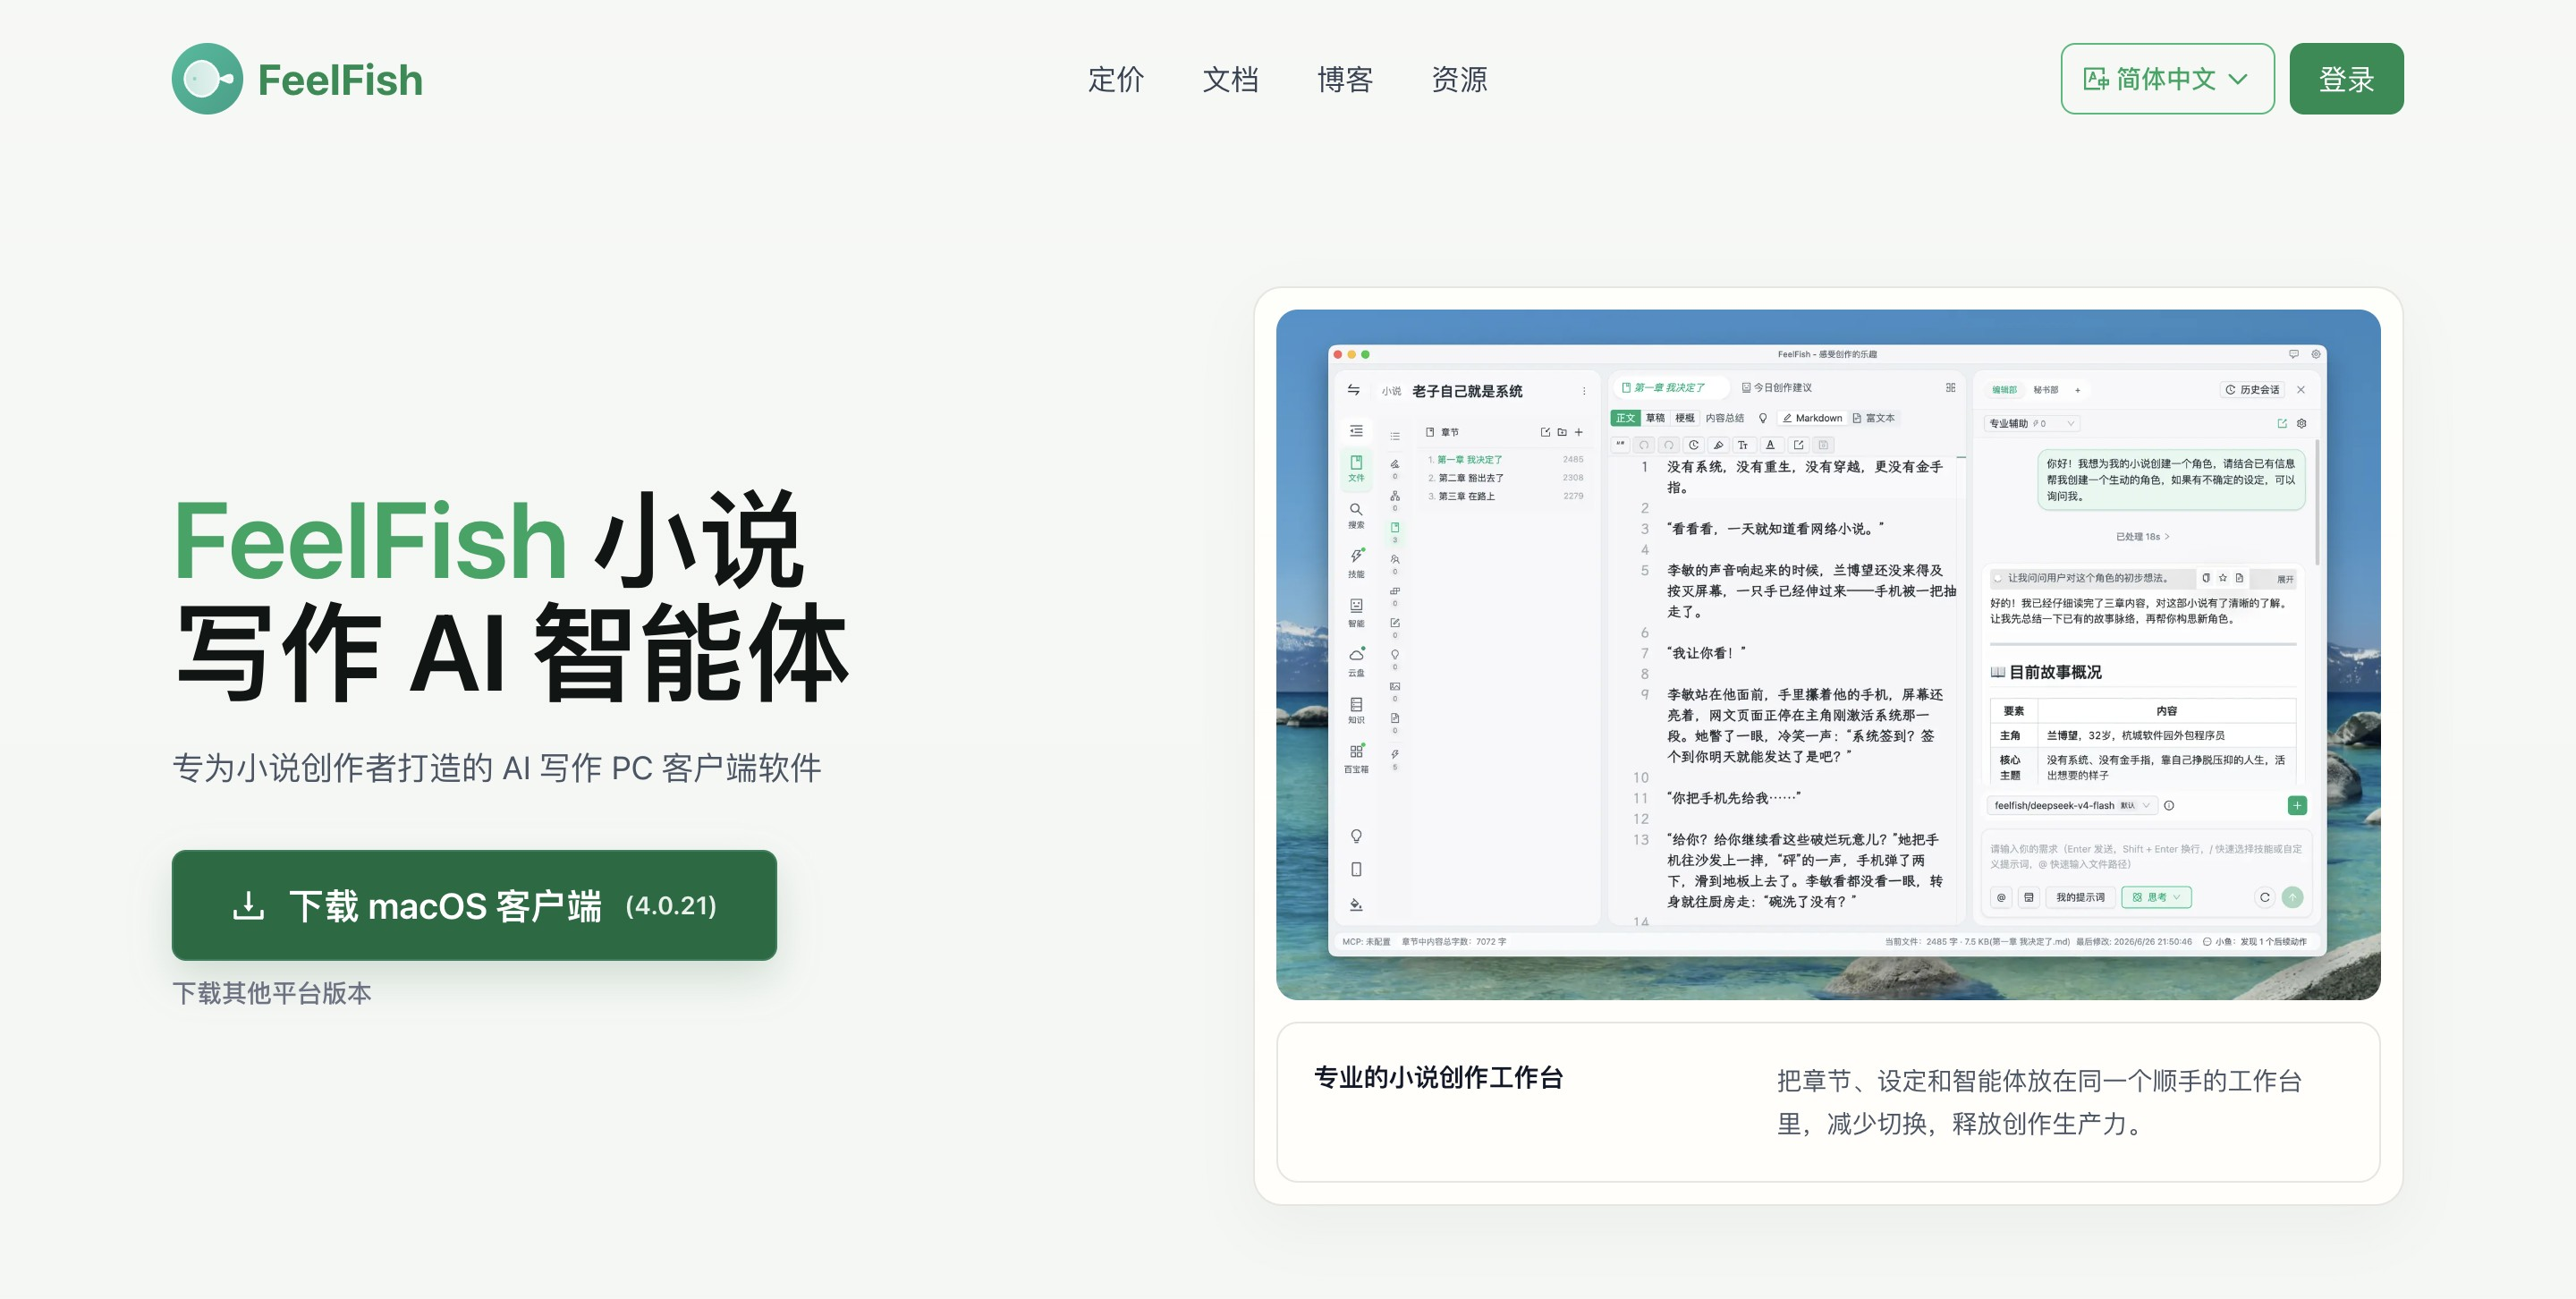 Đánh giá phần mềm viết tiểu thuyết AI mới nhất năm 2026: FeelFish 4.0Lập trình AIFeelFish 4.0 là phần mềm viết tiểu thuyết chuyên nghiệp, biến các mô hình AI quy mô lớn thành một đội ngũ viết lách am hiểu dự án. Phần mềm cung cấp khả năng quản lý dự án có cấu trúc, bao gồm chương, dàn ý, nhân vật và thiết lập, đồng thời hỗ trợ ngữ cảnh thông minh để duy trì tính nhất quán logic trong quá trình sáng tác tác phẩm dài. Công cụ này hỗ trợ cộng tác đa tác nhân tùy chỉnh, điều khiển từ xa trên máy tính và điện thoại, cùng đồng bộ đám mây và cỗ máy thời gian cục bộ để bảo đảm an toàn bản thảo, hướng đến việc cung cấp quy trình cộng tác hoàn chỉnh giữa người và AI cho tác giả tiểu thuyết mạng, kịch bản và các tác phẩm dài khác.00
 RabbitVis – Công cụ sản xuất thiết kế AI toàn diện do RabbitPre Intelligence phát triểnChỉnh sửa hình ảnhRabbitVis là công cụ sản xuất thiết kế AI toàn diện ở cấp độ lớp do RabbitPre Intelligence phát triển, dựa trên mô hình thị giác lớn UniWorld-Design do đội ngũ tự nghiên cứu, tích hợp sâu khả năng tạo nội dung AI với chỉnh sửa theo lớp. Công cụ hỗ trợ tạo áp phích, trang chi tiết sản phẩm thương mại điện tử, trang tạp chí và nhiều nội dung thiết kế chuyên nghiệp khác bằng ngôn ngữ tự nhiên, đồng thời cho phép chỉnh sửa liên tục ở cấp độ lớp như xóa nền, sửa văn bản, thay thế thành phần và tách tài nguyên trong suốt. Công cụ được tối ưu chuyên sâu cho tiếng Trung, hỗ trợ kiểu chữ nghệ thuật phức tạp, bố cục đan xen hình ảnh và văn bản, biểu đồ thông tin cùng các dạng bố cục mật độ cao khác. Hướng đến người dùng trong vận hành thương mại điện tử, truyền thông xã hội, quảng bá thương hiệu, sáng tạo nội dung và công việc văn phòng doanh nghiệp, ngay cả người không có nền tảng thiết kế cũng có thể tạo ra tài liệu hình ảnh chuyên nghiệp.00
 MemHarness – Khung tái cấu trúc bộ nhớ tác tử do Shanghai AI Lab và các đơn vị khác phát triểnTác nhân AIMemHarness là khung tái cấu trúc bộ nhớ cho LLM Agent do Shanghai AI Lab phối hợp với Đại học Chiết Giang, Đại học Phúc Đán, Đại học Giao thông Thượng Hải và các trường đại học khác phát triển. Khung chèn bước phê bình và tái cấu trúc giữa quá trình truy xuất và thực thi hành động, kết hợp với ngữ cảnh hiện tại để giữ lại, viết lại hoặc loại bỏ kinh nghiệm lịch sử. Thông qua huấn luyện đầu cuối bằng GRPO, khung không cần thêm dữ liệu gán nhãn thủ công. MemHarness hỗ trợ đầy đủ quy trình gồm truy xuất bộ nhớ, phê bình và tái cấu trúc, sinh hành động, ghi lại kinh nghiệm và cắt tỉa, đồng thời cung cấp quy trình ra quyết định gồm năm giai đoạn. Mô hình 7B tham số lần lượt vượt Gemini-2.5-Pro 23.1% và 39.7% trên ALFWorld và WebShop, với tỷ lệ thành công trung bình 85.9% trong các kịch bản ngoài phân phối. Khung phù hợp với các kịch bản như tác vụ gia đình của trí tuệ thể hiện, mua sắm trực tuyến tự động, chăm sóc khách hàng thông minh và hỗ trợ phát triển mã nguồn.10
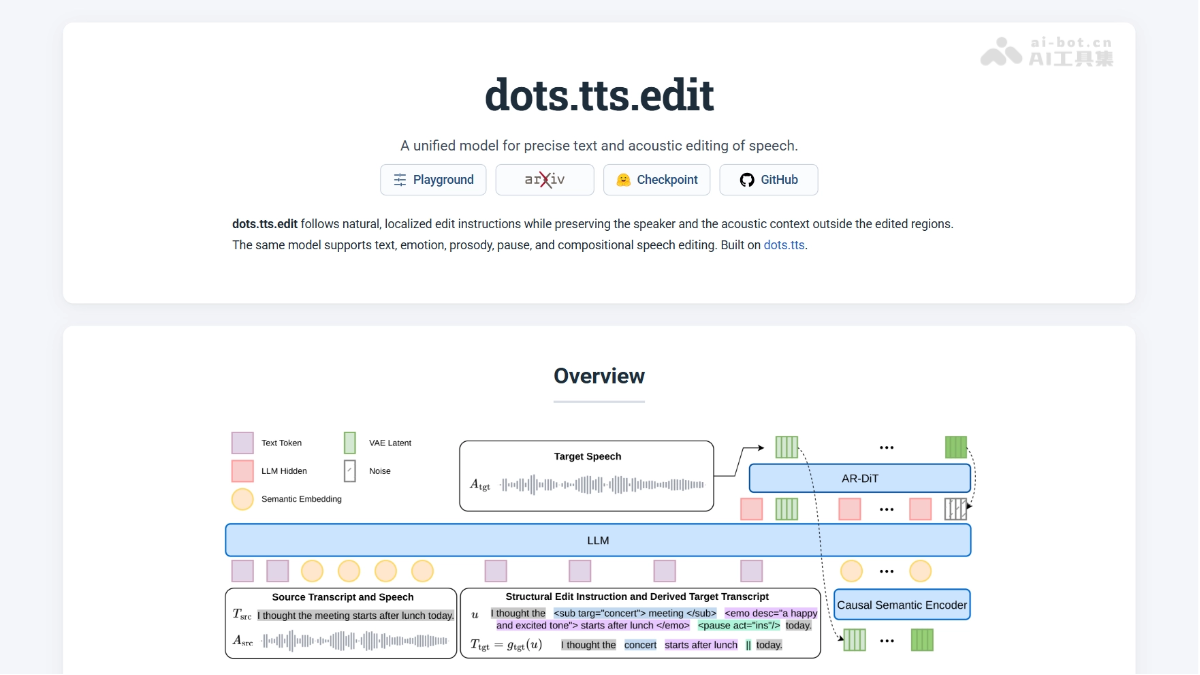 dots.ttsTổng hợp giọng nói AIdots.tts là mô hình nền tảng tổng hợp giọng nói tự hồi quy hoàn toàn liên tục với 2 tỷ tham số, do nhóm dots của Xiaohongshu và phòng thí nghiệm X-LANCE thuộc Đại học Giao thông Thượng Hải cùng mã nguồn mở. Mô hình trực tiếp tạo từng khối âm thanh 48kHz trong không gian ẩn liên tục, đạt...00
 SeedRealtime – Mô hình lớn song công âm thanh-video nguyên bản do ByteDance phát triểnMô hình AI lớnSeedRealtime – Mô hình lớn song công âm thanh-video nguyên bản do ByteDance phát triển là mô hình lớn song công âm thanh-video nguyên bản do đội ngũ Seed của ByteDance phát triển. Dựa trên kiến trúc thống nhất, mô hình tích hợp nguyên bản âm thanh, video và văn bản, mang đến tương tác thời gian thực toàn phương thức với khả năng vừa xem, vừa nghe, vừa nói. Các chức năng cốt lõi gồm hiểu kết hợp âm thanh-video, khả năng tương tác chủ động, nhịp độ tương tác mượt mà và nhận diện bối cảnh nhiều người. Mô hình có thể kết hợp bối cảnh hình ảnh để phân biệt các từ đồng âm, chủ động nhắc người dùng khi trạng thái hình ảnh thay đổi, phân biệt trò chuyện của người xung quanh với tiếng ồn nền trong môi trường ồn ào, đồng thời liên tục liên kết giọng nói với danh tính của từng người. Mô hình sử dụng cơ chế mô hình hóa thống nhất đầu cuối và tương tác song công nguyên bản, tránh tổn thất thông tin cùng độ trễ cộng dồn trong các hệ thống xâu chuỗi. Mô hình đã được triển khai đầy đủ trên ứng dụng Doubao, trở thành sản phẩm AI âm thanh-video song công đầu tiên trong ngành được triển khai ở quy mô lớn.10
 HOMIETạo video AIHOMIE là framework mã nguồn mở của Đại học Khoa học và Công nghệ Hồng Kông để tạo video kỹ thuật số, dựa trên backbone Wan2.1-T2V-14B và tích hợp mô hình ngôn ngữ đa phương thức lớn Qwen3-VL. Framework có thể xử lý thống nhất bốn yếu tố: người kỹ thuật số + sản phẩm + Logo + văn bản,...00
 SenseNova U1.5-Lite-Preview – Mô hình đa phương thức nhẹ do SenseTime mã nguồn mởMô hình AI lớnSenseNova U1.5-Lite-Preview – mô hình đa phương thức nhẹ do SenseTime mã nguồn mở, dựa trên kiến trúc NEO-Unify, sử dụng 8B-MoT tham số để thống nhất nguyên bản khả năng hiểu hình ảnh, suy luận, tạo và chỉnh sửa. Mô hình hỗ trợ tạo ảnh siêu nét 4K nguyên bản, với khả năng tái hiện kết cấu tinh tế, chất liệu chân thực và văn bản tiếng Trung, tiếng Anh trong bố cục phức tạp. Prompt Enhance Skill được tích hợp giúp giảm ngưỡng sáng tạo, cho phép thực hiện chính xác các chỉ thị ngôn ngữ tự nhiên dài và chỉ thị hình ảnh có cấu trúc, đồng thời hỗ trợ chỉnh sửa lặp liên tục. Hướng đến nhà thiết kế, nhà phát triển và người sáng tạo nội dung, mô hình cung cấp công cụ sáng tạo hình ảnh cấp thương mại với chi phí triển khai thấp và khả năng tuân thủ chỉ thị cao.10
 IndexTTS-2.5Tổng hợp giọng nói AIIndexTTS-2.5 là mô hình nhân bản giọng nói zero-shot cấp công nghiệp do Bilibili mã nguồn mở, chỉ có 0.8B tham số, hỗ trợ chuyển đổi liên ngôn ngữ giữa tiếng Trung, tiếng Anh, tiếng Nhật, tiếng Tây Ban Nha và tiếng Ả Rập.00
 Moshi出门问问Nền tảng học tập AIMoshi出门问问 là công ty cung cấp các sản phẩm và giải pháp trí tuệ nhân tạo, hoạt động trong các lĩnh vực như tạo nội dung, tương tác bằng giọng nói, chuyển đổi bản ghi âm thành văn bản và phần cứng thông minh. Người dùng có thể chọn công cụ lồng tiếng bằng trí tuệ nhân tạo, người kỹ thuật số hoặc sáng tạo video tùy theo nhiệm vụ, đồng thời sử dụng TicNote để ghi âm, chuyển lời nói thành văn bản theo thời gian thực, tạo bản tóm tắt và hỏi đáp. Dịch vụ phù hợp với nhà sáng tạo video ngắn, người làm marketing và truyền thông tự thân, nhân viên văn phòng cần sắp xếp tài liệu cuộc họp, cũng như doanh nghiệp đang khám phá các dịch vụ số hóa. Nền tảng cung cấp cả sản phẩm miễn phí và trả phí; cần tìm hiểu riêng về tính năng và cách sử dụng của từng sản phẩm. Nội dung được tạo và kết quả chuyển đổi giọng nói thành văn bản cũng nên được kiểm tra thủ công.018
 Qwen 3.8-Max – Mô hình ngôn ngữ hàng đầu do đội ngũ Qwen của Alibaba Cloud phát triểnMô hình AI lớnQwen 3.8-Max – mô hình ngôn ngữ hàng đầu do đội ngũ Qwen của Alibaba Cloud phát triển, được mở rộng trên kiến trúc Qwen 3.5 lên 2.4 nghìn tỷ tham số, định vị là mô hình ngôn ngữ quy mô cực lớn dành cho doanh nghiệp và nghiên cứu khoa học. Mô hình hỗ trợ lập trình tự động dài hạn, tái hiện bài báo khoa học, thi đấu thực tế, nâng cao hiệu suất văn phòng, phát triển chiến lược định lượng và tự thiết kế chip cùng nhiều kịch bản giá trị cao khác. Thông qua học tăng cường trong thế giới thực và vòng lặp phản hồi tự tiến hóa, mô hình có thể tự thực thi từ vài ngày đến vài chục ngày, hoàn thành các tác vụ phức tạp mà không cần can thiệp thủ công. Người dùng có thể gọi API thông qua nền tảng Qianwen AI với giao thức tương thích OpenAI hoặc Anthropic, hoặc triển khai trọng số mã nguồn mở tại chỗ để dễ dàng tích hợp vào các framework tác tử thông minh như Claude Code, Codex và Qoder. Nhờ đó, các nhóm nghiên cứu phát triển, chuyên gia pháp lý và tuân thủ, nhà thiết kế cùng những người dùng chuyên môn khác có thể nâng cao đáng kể hiệu suất làm việc, rút ngắn các dự án kéo dài thành sản phẩm hoàn tất trong một cuộc hội thoại.10
Tất cả công cụ có thẻ này được hiển thị.