
- Lượt truy cập hàng tháng
- 0
- Giá
- Miễn phí và Trả phí
- Được liệt kê
- 2026-08-13
- Đã cập nhật
- 2026-08-13
01dots.tts là gì
dots.tts là mô hình nền tảng tổng hợp giọng nói tự hồi quy hoàn toàn liên tục với 2 tỷ tham số, do nhóm dots của Xiaohongshu và phòng thí nghiệm X-LANCE thuộc Đại học Giao thông Thượng Hải cùng mã nguồn mở. Mô hình trực tiếp tạo từng khối âm thanh 48kHz trong không gian ẩn liên tục, đạt SOTA về độ tương đồng giọng nói và độ chính xác nội dung trên các benchmark như Seed-TTS-Eval, đồng thời hỗ trợ sao chép giọng nói zero-shot, đầu ra streaming và hội thoại song công độ trễ thấp. Dự án công khai toàn bộ mã nguồn và trọng số, đồng thời mở rộng khả năng chỉnh sửa giọng nói chính xác với dots.tts.edit.
02Các tính năng chính của dots.tts
Sao chép giọng nói zero-shot: chỉ cần 3–10 giây âm thanh tham chiếu để tái tạo giọng nói đó khi đọc bất kỳ văn bản mới nào, hỗ trợ sao chép đa ngôn ngữ và đạt hiệu năng SOTA về độ chính xác nội dung cùng độ tương đồng người nói trên benchmark Seed-TTS-Eval.
Tổng hợp văn bản thành giọng nói: cung cấp khả năng tạo giọng nói chất lượng cao từ lấy mẫu giọng ngẫu nhiên đến giọng người nói được chỉ định, trực tiếp xuất âm thanh 48 kHz dựa trên mô hình tự hồi quy liên tục 2B tham số.
Tạo streaming và tương tác độ trễ thấp: hỗ trợ đầu ra streaming tự nhiên, có thể tạo âm thanh từng khối ngay sau khi nhập tiền tố văn bản; trong chế độ hai luồng 1T1A, phía giọng nói phản hồi ngay khi LLM thượng nguồn xuất một Token văn bản, với độ trễ gói âm thanh đầu tiên thấp tới 54.4 mili giây, phù hợp với Agent giọng nói thời gian thực và hội thoại song công.
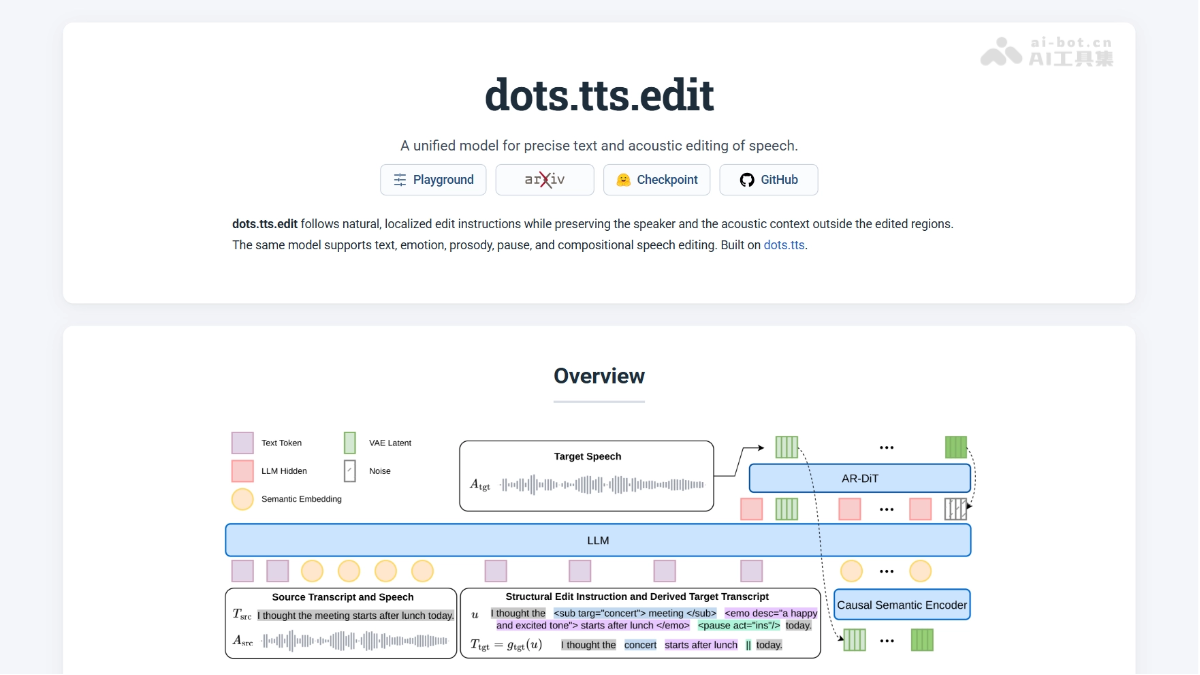
Chỉnh sửa giọng nói chính xác: hỗ trợ thay thế văn bản, điều chỉnh cảm xúc, thay đổi cao độ và tốc độ nói, chèn hoặc xóa khoảng dừng trong bản ghi hiện có; có thể kết hợp nhiều thao tác và hoàn tất trong một lệnh, trong khi các vùng không chỉnh sửa vẫn được giữ nguyên.
Hỗ trợ đa ngôn ngữ: bao phủ 24 ngôn ngữ, đạt độ tương đồng người nói trung bình 83.9 trong đánh giá đa ngôn ngữ MiniMax, trong đó 19 ngôn ngữ đạt hạng nhất ở từng hạng mục.
Nhiều mức tốc độ suy luận: cung cấp nhiều checkpoint gồm Base, SOAR, MeanFlow (4 bước), sCM hai bước và DMD một bước, cho phép người dùng lựa chọn giữa chất lượng âm thanh và tốc độ suy luận theo nhu cầu.
03Nguyên lý kỹ thuật của dots.tts
Theo dõi WeChat và trả lời “开源” để tham gia nhóm trao đổi dự án mã nguồn mở AI
Kiến trúc tự hồi quy hoàn toàn liên tục: dots.tts loại bỏ cách tiếp cận truyền thống là lượng tử hóa giọng nói thành Token rời rạc. Toàn bộ chuỗi tạo sinh hoạt động hoàn toàn trong không gian ẩn liên tục: mô hình dự đoán từng khối đoạn âm học theo phương thức tự hồi quy, sau đó khôi phục thành dạng sóng 48 kHz bằng bộ giải mã phong cách BigVGAN, qua đó tránh về bản chất nút thắt thông tin và tổn thất chi tiết giọng nói do lượng tử hóa rời rạc gây ra.
Biểu diễn liên tục giàu ngữ nghĩa: mô hình sử dụng AudioVAE được thiết kế dựa trên HoliTok để nén dạng sóng gốc thành biến ẩn liên tục ở 25 FPS. Bộ mã hóa đạt sự cân bằng giữa độ trung thực khi tái tạo và cấu trúc hóa không gian ẩn thông qua huấn luyện ngữ nghĩa, giúp độ tương đồng người nói sau tái tạo đạt 0.969, đồng thời bảo toàn nhiều chi tiết giọng nói và âm học cho quá trình tạo sinh tự hồi quy tiếp theo.
Cơ chế kiểm soát sai số: trước vấn đề cố hữu trong tự hồi quy liên tục, khi sai lệch nhỏ ở bước trước tích lũy và lan truyền về sau, dots.tts đưa vào bộ mã hóa ngữ nghĩa nhân quả để nén các VAE patch đã tạo thành lịch sử ngữ nghĩa cô đọng theo thời gian thực và đưa ngược lại cho mô hình ngôn ngữ lớn; bằng cách loại bỏ các biến đổi âm học cục bộ có phương sai cao và chỉ giữ lại tóm tắt ngữ nghĩa dài hạn, mô hình giảm hiệu quả lan truyền sai số, tiếng rít và hiện tượng trôi giọng trong quá trình tạo chuỗi dài.
Quy trình tạo sinh: quá trình tạo sinh lấy mô hình ngôn ngữ lớn làm trung tâm, được khởi tạo dựa trên Qwen2.5-1.5B, trực tiếp tiếp nhận Token văn bản BPE và xuất trạng thái ẩn ở mỗi bước; sau đó, đầu tự hồi quy khớp dòng (DiT 18 lớp) thực hiện khử nhiễu để tạo acoustic patch tiếp theo dựa trên trạng thái ẩn của LLM và tiền tố tự hồi quy, đồng thời sử dụng x-vector toàn cục do bộ mã hóa người nói CAM++ đóng băng cung cấp để đảm bảo tính nhất quán của giọng nói.
Tăng tốc hậu huấn luyện: nhóm phát triển sử dụng căn chỉnh tự sửa lỗi SOAR để mô phỏng trạng thái lệch khỏi suy luận thực tế trong quá trình huấn luyện và giúp mô hình học cách tự sửa, cải thiện độ ổn định mà không cần mô hình phần thưởng; sử dụng chưng cất MeanFlow để nén quỹ đạo nhiều bước của mô hình giáo viên thành vận tốc trung bình, đạt chất lượng cao với 4 bước; nén xuống 2 bước bằng mô hình nhất quán đơn giản hóa (sCM); kết hợp chưng cất khớp phân phối nhận biết phần thưởng (DMD) với chiến lược cập nhật hai thang thời gian để tạo mô hình một bước chất lượng cao, tự nhiên và rõ ràng.
04Cách sử dụng dots.tts
Cài đặt: chạy pip install dots.tts để cài đặt, hoặc sao chép mã nguồn từ GitHub rồi chạy pip install -e . để cài đặt phục vụ phát triển cục bộ. Trong trường hợp cần tính đồng thời cao, có thể triển khai thêm SGLang Omni để được tăng tốc CUDA Graph và hỗ trợ batching liên tục.
Tổng hợp qua dòng lệnh: sử dụng entry point dots.tts và chỉ định --model-name-or-path, --text cùng --prompt-audio và --prompt-text mục tiêu để thực hiện sao chép giọng zero-shot; bỏ qua --prompt-text sẽ chuyển sang sao chép x-vector, còn bỏ qua --prompt-audio sẽ thực hiện lấy mẫu giọng ngẫu nhiên.
Chỉnh sửa qua dòng lệnh: sử dụng entry point dots.tts.edit, cung cấp --source-audio và --instruction theo phong cách XML để thực hiện thay thế văn bản, chỉnh sửa cảm xúc hoặc ngữ điệu trên bản ghi hiện có.
Gọi cơ bản qua Python API: tải mô hình bằng DotsTtsRuntime.from_pretrained(), sau đó gọi generate(), truyền văn bản cùng âm thanh tham chiếu tùy chọn để nhận tensor âm thanh tổng hợp và lưu thành tệp.
Đầu ra streaming qua Python API: gọi generate_stream() để nhận tensor âm thanh từng khối, truyền theo thời gian thực tới trình phát hoặc WebSocket, tạo trải nghiệm vừa tạo vừa phát với độ trễ thấp.
Hội thoại hai luồng qua Python API: khởi động phiên bằng DotsTtsRuntimeDoubleStreaming rồi truyền văn bản theo từng Token, phía giọng nói lập tức bắt đầu tạo. Độ trễ gói âm thanh đầu tiên có thể thấp tới 54.4 mili giây, phù hợp với Agent giọng nói thời gian thực.
Tinh chỉnh: chạy accelerate launch scripts/train_dots_tts.py và cấu hình đường dẫn dữ liệu riêng để tinh chỉnh thích ứng giọng nói hoặc lĩnh vực dựa trên checkpoint công khai.
Tăng tốc bằng chưng cất: sử dụng scripts/train_dots_tts_meanflow.py với checkpoint SOAR làm giáo viên để thực hiện chưng cất MeanFlow, thu được mô hình học sinh chất lượng cao với 4, 2 hoặc 1 bước, đáp ứng các nhu cầu khác nhau về độ trễ và tính đồng thời.
Giao diện Web: chạy python apps/gradio/app.py để khởi động giao diện tổng hợp trực quan, hoặc chạy apps/edit_playground/app.py để khởi động Edit Playground, cho phép tải âm thanh lên, đánh dấu khoảng cần chỉnh sửa và xem trước kết quả theo thời gian thực.
05Ưu thế cốt lõi của dots.tts
Mô hình hóa không gian ẩn hoàn toàn liên tục: loại bỏ acoustic Token rời rạc và trực tiếp tạo sinh tự hồi quy trong không gian ẩn liên tục, bảo toàn các chi tiết giọng nói phong phú như chất lượng phổ và âm hơi, với độ tương đồng người nói khi tái tạo lên tới 0.969.
Chất lượng tổng hợp SOTA: đồng thời đạt SOTA về độ chính xác nội dung và độ tương đồng giọng nói trên benchmark Seed-TTS-Eval; đạt SIM trung bình 83.9 trong đánh giá MiniMax với 24 ngôn ngữ, vượt các giải pháp phổ biến về hiệu năng tổng thể.
Streaming tự nhiên, độ trễ thấp: chế độ hai luồng 1T1A có độ trễ gói âm thanh đầu tiên thấp tới 54.4 mili giây. Kết hợp với SGLang Omni, một GPU H100 đạt thông lượng 16 luồng đồng thời ở mức 4.76 req/s, đáp ứng nhu cầu của Agent giọng nói thời gian thực.
Khả năng chỉnh sửa thống nhất: dots.tts.edit sử dụng cùng một mô hình nền tảng, hỗ trợ chỉnh sửa chính xác văn bản, cảm xúc, ngữ điệu và khoảng dừng bằng chỉ thị có cấu trúc XML, đồng thời dẫn đầu tổng thể so với các hệ thống mã nguồn mở khác trong đánh giá doteBench.
06Địa chỉ dự án dots.tts
Kho GitHub:https://github.com/studio-dots-ai/dots.tts
Bài báo kỹ thuật arXiv:https://arxiv.org/pdf/2608.02673
07Các kịch bản ứng dụng của dots.tts
Agent giọng nói thời gian thực: chế độ hai luồng 1T1A có độ trễ gói đầu tiên thấp tới 54.4 mili giây, phù hợp với hội thoại song công thời gian thực và trợ lý giọng nói do LLM điều khiển.
Sao chép giọng zero-shot: chỉ cần vài giây âm thanh tham chiếu để tái tạo bất kỳ giọng nói nào, hỗ trợ sao chép đa ngôn ngữ, phù hợp với sách nói, lồng tiếng và sáng tạo nội dung cá nhân hóa.
Tạo nội dung đa ngôn ngữ: bao phủ 24 ngôn ngữ và vẫn duy trì độ tương đồng người nói cao, phù hợp với phát giọng nói đa ngôn ngữ và dịch vụ bản địa hóa cho các sản phẩm toàn cầu.
Chỉnh sửa giọng nói chính xác: sử dụng dots.tts.edit để thay thế văn bản, điều chỉnh cảm xúc, sửa ngữ điệu và điều chỉnh khoảng dừng trong bản ghi hiện có, phù hợp với hậu kỳ podcast và tinh chỉnh nội dung âm thanh.
Phát trực tiếp và phát tin thời gian thực: kết hợp với đầu ra streaming của LLM để vừa tạo vừa phát, phù hợp với phát tin tức, bán hàng livestream và phát thông tin thời gian thực.
© Tuyên bố miễn trừ trách nhiệm: tên miền và nội dung được liên kết có thể thay đổi theo thời gian. AIEZZ không kiểm soát các trang web của bên thứ ba. Hãy tự đánh giá nội dung bên ngoài và các rủi ro liên quan.
Đánh giá của người dùng0