
- Lượt truy cập hàng tháng
- 0
- Giá
- Chưa đặt
- Được liệt kê
- —
- Đã cập nhật
- 2026-11-03
01MOSS-Live là gì
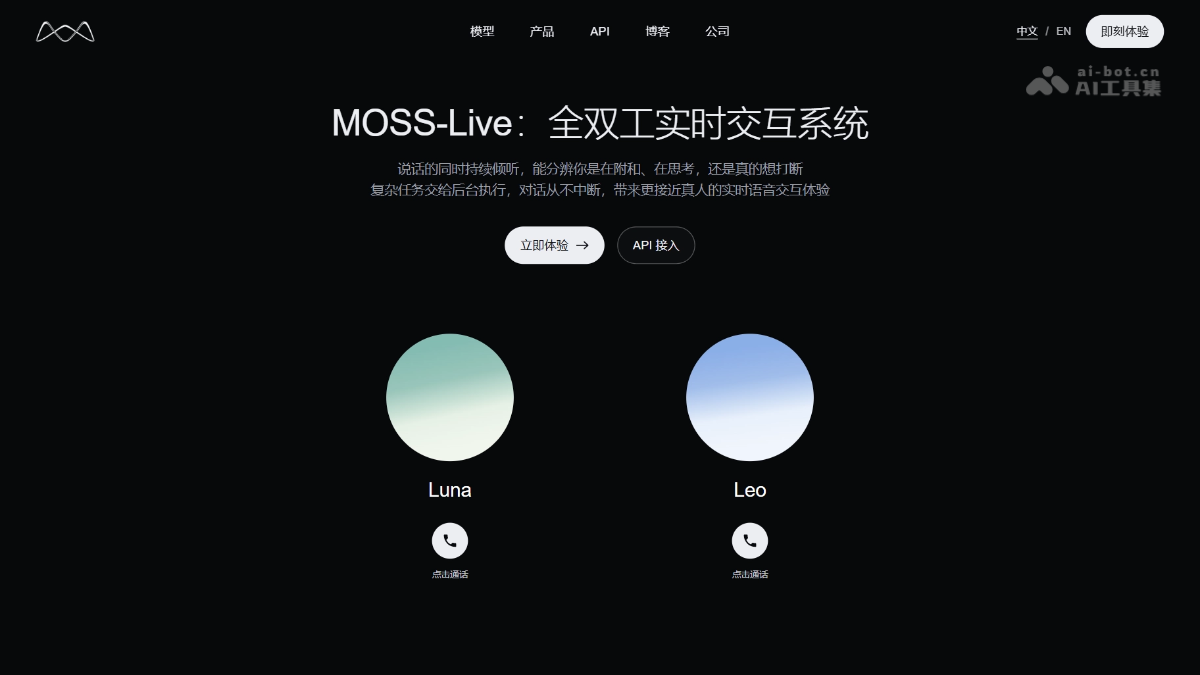
MOSS-Live là hệ thống tương tác thời gian thực song công toàn phần do Mosi Intelligence phát triển. MOSS-Live cho phép AI vừa nghe vừa nói như người thật, phán đoán ở cấp độ ngữ nghĩa khi nào nên phản hồi, chờ đợi hoặc chấp nhận ngắt lời, không bị kích hoạt nhầm bởi âm thanh phụ họa và tiếng ồn môi trường; hỗ trợ cuộc gọi video, chia sẻ màn hình và hiểu âm thanh môi trường; sử dụng kiến trúc phối hợp tiền cảnh-hậu cảnh, cho phép hoàn thành không đồng bộ các tác vụ phức tạp như tra cứu thông tin và lập kế hoạch mà không làm gián đoạn cuộc trò chuyện, đồng thời chủ động phản hồi kết quả sau khi hoàn tất. MOSS-Live dẫn đầu nhiều chỉ số trong các bài đánh giá so với các sản phẩm cạnh tranh như GPT Realtime; API được mở miễn phí trong thời gian giới hạn.
02Các tính năng chính của MOSS-Live
Hội thoại song công toàn phần: vừa nghe vừa nói, phán đoán ở cấp độ ngữ nghĩa thời điểm phản hồi, chờ đợi, chấp nhận ngắt lời hoặc giữ im lặng.
Ngắt lời theo ngữ nghĩa: phân biệt âm thanh phụ họa và ngắt lời chủ động, không bị gián đoạn bởi những phản hồi ngắn như “ừm”, đồng thời phản hồi kịp thời khi bị ngắt lời rõ ràng.
Phán đoán kết thúc lượt nói theo ngữ nghĩa: dựa trên hiểu biết ngữ nghĩa để xác định người dùng đã nói xong hay chưa; chủ động chờ khi người dùng dừng hoặc suy nghĩ giữa câu, không nói chen.
Từ chối âm thanh không liên quan: phân biệt lời nói dành cho mình, không bị kích hoạt nhầm bởi cuộc trò chuyện của người khác, lời tự nói hoặc âm thanh phát từ thiết bị.
Phụ họa tự nhiên: chủ động đưa ra phản hồi ngắn vào thời điểm phù hợp dựa trên nội dung và nhịp điệu hội thoại.
Tiếp tục nói từ điểm dừng và ghi nhớ: dù bị ngắt lời nhiều lần hoặc chuyển chủ đề, hệ thống vẫn nhớ vị trí bị gián đoạn và ngữ cảnh, có thể tiếp tục tự nhiên.
Tương tác chủ động: liên tục theo dõi cuộc trò chuyện theo các điều kiện người dùng đặt trước và chủ động tham gia khi điều kiện được đáp ứng.
Vừa trò chuyện vừa xử lý công việc: gọi công cụ để thực hiện không đồng bộ các tác vụ như truy vấn và lập kế hoạch, không làm gián đoạn cuộc trò chuyện, đồng thời chủ động phản hồi kết quả khi hoàn tất.
Vừa nghe vừa dịch: phiên dịch đồng thời dạng streaming, liên tục xuất bản dịch với độ trễ thấp gần như phiên dịch viên thực tế.
Nhận thức đa phương thức: hỗ trợ cuộc gọi video và chia sẻ màn hình, có thể hiểu âm thanh môi trường và chất giọng người nói, kết hợp thông tin hình ảnh, giọng nói và môi trường để tương tác.
03Nguyên lý kỹ thuật của MOSS-Live
Kiến trúc phối hợp tiền cảnh-hậu cảnh: MOSS-Live tách rời tương tác thời gian thực và các tác vụ phức tạp, phân công cho các mô hình khác nhau: mô hình tương tác tiền cảnh liên tục tiếp nhận giọng nói, hình ảnh và âm thanh môi trường, hiểu trạng thái hội thoại rồi quyết định thời điểm lắng nghe, phản hồi hoặc chờ đợi; mô hình hậu cảnh đảm nhận các tác vụ cần suy luận chuyên sâu và thực thi dài hạn. Hai mô hình phối hợp thông qua bộ nhớ, ngữ cảnh và trạng thái tác vụ dùng chung. Mô hình tiền cảnh nắm được tiến độ của tác vụ hậu cảnh, sau đó đưa kết quả trở lại cuộc trò chuyện vào thời điểm phù hợp khi tác vụ hoàn tất, giúp người dùng tiếp tục trao đổi mà không cần chờ đợi.
Điều khiển song công toàn phần ở cấp độ ngữ nghĩa: trong quá trình liên tục lắng nghe, MOSS-Live hiểu theo thời gian thực ngữ nghĩa, ý định nói và trạng thái hội thoại, linh hoạt phán đoán khi nào nên phản hồi, khi nào nên chờ, khi nào chấp nhận ngắt lời và khi nào giữ im lặng, tạo nên khả năng nghe nói song song thực sự tự nhiên.
Nhận thức đa phương thức liên tục: hệ thống liên tục kết hợp ba nguồn thông tin: luồng giọng nói, hình ảnh video và môi trường âm học. Quyết định tương tác dựa trên sự hiểu tổng hợp thông tin đa phương thức, chẳng hạn kết hợp hình ảnh thời gian thực để nhận diện vật thể người dùng đang chỉ, hoặc nhận diện âm thanh không liên quan như thông báo dẫn đường và từ chối phản hồi.
04Cách sử dụng MOSS-Live
Trải nghiệm trực tuyến trên website chính thức: truy cập website chính thức của Mosi Intelligence https://www.moss.cn, nhấp vào mục “Trải nghiệm MOSS Live”, đăng ký và đăng nhập, sau đó cấp quyền cho micrô/camera; bạn có thể chọn giọng nói để bắt đầu hội thoại thoại song công toàn phần.
Tích hợp API: truy cập https://platform.moss.cn, đăng ký tài khoản nhà phát triển, tạo ứng dụng để lấy khóa và tích hợp giao diện song công toàn phần theo tài liệu chính thức, từ đó nhúng MOSS-Live vào sản phẩm của mình.
05Ưu thế cốt lõi của MOSS-Live
Kiểm soát nhịp hội thoại dẫn đầu ngành: tỷ lệ nói chen khi người dùng tạm dừng chỉ 1.44%, thấp hơn nhiều so với GPT Realtime 2.1 và Doubao SeedDuplex; thời điểm chờ và tiếp lời tự nhiên nhất.
Khả năng từ chối âm thanh không liên quan mạnh: tỷ lệ phản hồi nhầm với giọng nói không liên quan chỉ 2%, trong khi các sản phẩm cạnh tranh được đánh giá lên tới 68%–88%; không bị kích hoạt nhầm bởi cuộc trò chuyện của người khác hoặc âm thanh phát từ thiết bị.
Chất lượng xử lý ngắt lời cao nhất: chất lượng câu trả lời sau khi bị ngắt lời trong FDB v1 đạt 4.88/5 điểm; không bị gián đoạn bởi âm thanh phụ họa, có thể phản hồi kịp thời và tiếp nối ngữ cảnh khi người dùng thực sự ngắt lời.
Hội thoại và tác vụ chạy song song: kiến trúc phối hợp tiền cảnh-hậu cảnh cho phép thực hiện không đồng bộ các tác vụ phức tạp ở hậu cảnh, không chặn cuộc trò chuyện và chủ động phản hồi kết quả sau khi hoàn tất.
Nhận thức đa phương thức theo thời gian thực: đồng thời kết hợp giọng nói, hình ảnh video, chia sẻ màn hình và âm thanh môi trường, tạo ra tương tác toàn phương thức “vừa nhìn, vừa nghe, vừa trò chuyện”.
Khả năng tiếp tục từ điểm dừng mạnh: dù bị ngắt lời nhiều lần hoặc chuyển chủ đề thường xuyên, hệ thống vẫn nhớ vị trí phát biểu và ngữ cảnh, tự nhiên tiếp tục nội dung trước đó.
Hỗ trợ phiên dịch đồng thời dạng streaming: vừa nghe vừa dịch, liên tục xuất bản dịch với độ trễ thấp gần như phiên dịch đồng thời thực tế, phù hợp với các tình huống giao tiếp đa ngôn ngữ.
06Địa chỉ dự án MOSS-Live
Website dự án: https://www.moss.cn/products/moss-live
07Các kịch bản ứng dụng của MOSS-Live
Tham dự hội nghị AI: đóng vai trò người tham dự ảo theo dõi thảo luận theo thời gian thực, tiếp nối ngữ cảnh sau khi bị ngắt lời, tự động tổng hợp kết luận và việc cần làm sau cuộc họp.
Trợ lý giọng nói trên xe: lập kế hoạch hành trình, tra cứu vé tàu và khách sạn trong lúc lái xe, chống nhiễu từ thông báo dẫn đường, vẫn có thể tiếp tục lộ trình từ điểm dừng sau nhiều lần bị ngắt lời.
Hướng dẫn viên du lịch cá nhân: nhận diện tòa nhà trước mắt qua video và giới thiệu lịch sử, có thể ngắt lời bất cứ lúc nào để tra cứu giá phòng hoặc nhà hàng; phần thuyết minh tự nhiên mở rộng theo mối quan tâm của du khách.
Phiên dịch đồng thời đa ngôn ngữ: vừa nghe vừa dịch trong hội nghị quốc tế hoặc giao tiếp đa ngôn ngữ, liên tục xuất bản bản dịch với độ trễ thấp gần như phiên dịch đồng thời thực tế.
Luyện tập học tập và nhắc nhở: sửa lỗi theo thời gian thực khi học thuộc, theo dõi các nội dung quan trọng trong cuộc họp và chủ động tham gia nhắc nhở khi điều kiện đặt trước được đáp ứng.
© Tuyên bố miễn trừ trách nhiệm: tên miền và nội dung được liên kết có thể thay đổi theo thời gian. AIEZZ không kiểm soát các trang web của bên thứ ba. Hãy tự đánh giá nội dung bên ngoài và các rủi ro liên quan.
Đánh giá của người dùng0