
- Lượt truy cập hàng tháng
- 0
- Giá
- Chưa đặt
- Được liệt kê
- —
- Đã cập nhật
- 2026-11-04
01EvaOmni là gì
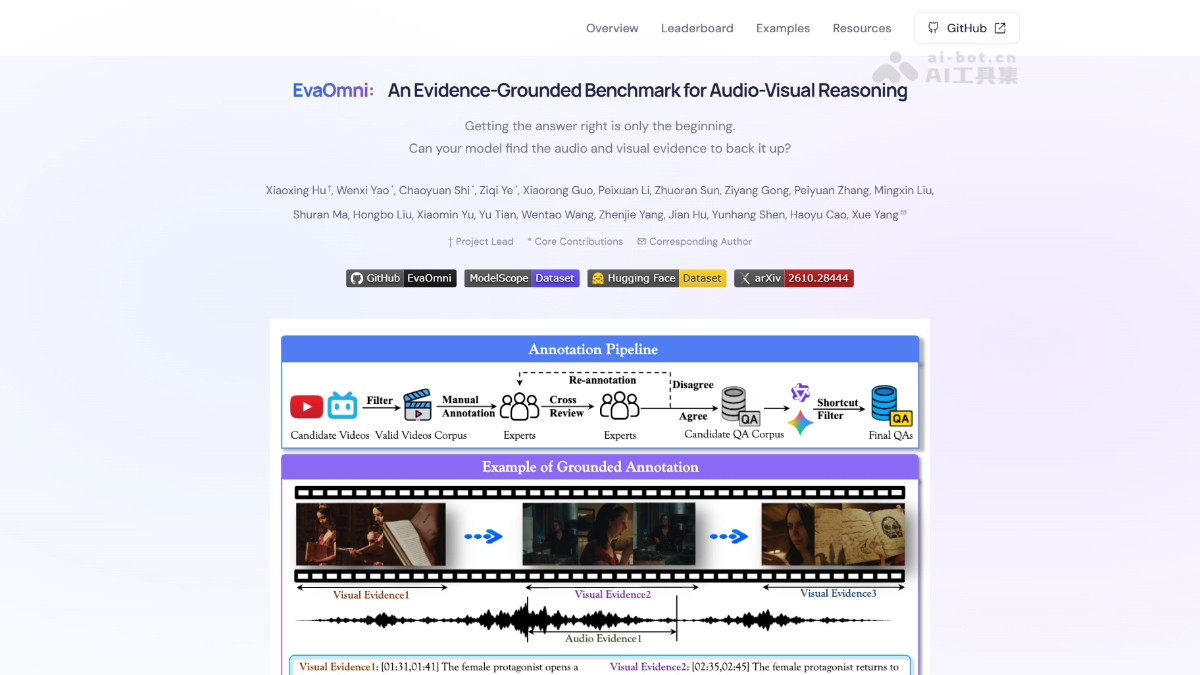
EvaOmni là bộ tiêu chuẩn đánh giá mô hình ngôn ngữ lớn đa phương thức toàn diện do Đại học Giao thông Thượng Hải, Đại học Phúc Đán, Tencent YouTu và các bên khác phát hành mã nguồn mở, gồm 392 video thực tế và 1.027 câu hỏi-trả lời được gán nhãn thủ công, bao phủ 15 năng lực và 3 cấp độ suy luận. EvaOmni yêu cầu đồng thời đưa ra câu trả lời và các khoảng thời gian bằng chứng trong âm thanh, video, sau đó chấm điểm theo ba chỉ số: độ chính xác câu trả lời, độ bao phủ bằng chứng và khả năng định vị hai phương thức. Trong 24 mô hình được kiểm thử, Gemini3.7-Flash mạnh nhất đạt độ chính xác 79.4%, nhưng khả năng định vị hai phương thức chỉ đạt 35.1%, chênh 59.2 điểm phần trăm so với 94.3% của chuyên gia con người, cho thấy điểm yếu là trả lời đúng nhưng không thể chỉ ra căn cứ.
02Các chức năng chính của EvaOmni
Đánh giá câu trả lời: xác định câu trả lời của mô hình trong các câu hỏi trắc nghiệm nghe nhìn có chính xác hay không, đồng thời đưa ra độ chính xác Acc.
Gán nhãn và trả về bằng chứng: mỗi câu hỏi được gán nhãn thủ công các khoảng thời gian âm thanh và video hỗ trợ cho đáp án; mô hình phải trả về các khoảng bằng chứng hai phương thức cùng với câu trả lời.
Điểm độ bao phủ bằng chứng (C.G.): thống kê tỷ lệ các đoạn bằng chứng do con người gán nhãn được các khoảng dự đoán của mô hình bao phủ, đo lường mức độ mô hình tìm đủ các manh mối hỗ trợ.
Định vị điểm nghẽn hai phương thức (B.G.): tính IoU theo thời gian riêng cho âm thanh và video, sau đó lấy phương thức yếu hơn để chấm điểm, yêu cầu cả hai phương thức đều được định vị chính xác.
Phân tầng năng lực thành ba cấp: chia nhiệm vụ thành truy xuất và định vị, hiểu cơ bản, suy luận phức tạp, kiểm tra khoảng năng lực từ căn chỉnh điểm đơn đến suy luận nhiều bước.
Lọc lối tắt: sàng lọc câu hỏi bằng đầu vào đơn phương thức gồm văn bản, âm thanh và hình ảnh, loại bỏ các mẫu có thể trả lời đúng chỉ dựa vào một phương thức hoặc kiến thức thông thường từ văn bản.
Đánh giá mô hình theo chiều ngang: cung cấp tiêu chuẩn thống nhất và bảng xếp hạng cho 24 mô hình đa phương thức toàn diện, hỗ trợ so sánh và lựa chọn giữa mô hình có trọng số mở và mô hình độc quyền.
03Nguyên lý kỹ thuật của EvaOmni
Theo dõi WeChat và trả lời “开源” để tham gia nhóm trao đổi dự án AI mã nguồn mở
Cấu trúc dữ liệu gán nhãn nhận biết bằng chứng: EvaOmni đồng thời gán nhãn khoảng bằng chứng âm thanh và video cho mỗi câu hỏi, kèm một tập phương án gây nhiễu được thiết kế dựa trên nội dung video. Vì vậy, đầu ra của mô hình được định nghĩa là bộ ba gồm lựa chọn, tập dấu thời gian âm thanh và tập dấu thời gian video. Chương trình đánh giá có thể kiểm tra riêng độ chính xác của câu trả lời và chất lượng định vị bằng chứng.
Quy trình xây dựng dữ liệu gồm bốn giai đoạn: sản xuất dữ liệu trải qua sàng lọc video, gán nhãn thủ công, kiểm duyệt chéo và lọc lối tắt. Trước tiên loại bỏ các video chứa phụ đề được mã hóa cứng hoặc bị văn bản che phủ trên diện rộng để bảo đảm manh mối nghe nhìn chân thực và hiệu quả; chuyên gia biên soạn câu hỏi, thiết kế các phương án gây nhiễu gắn với nội dung video và gán nhãn khoảng bằng chứng của hai phương thức; những người gán nhãn khác kiểm duyệt chéo việc phân loại năng lực, chất lượng bằng chứng và vấn đề lối tắt, còn các mẫu gây tranh cãi được hai chuyên gia bổ sung xem xét độc lập; yêu cầu mô hình trả lời riêng với ba loại đầu vào đơn phương thức: chỉ văn bản, chỉ âm thanh và chỉ hình ảnh. Mọi câu hỏi có thể được trả lời đúng bằng một phương thức đơn lẻ đều được sửa và gán nhãn lại, ngăn chặn lối tắt “bỏ qua suy luận kết hợp nghe nhìn” ngay từ tầng dữ liệu.
Hệ thống chấm điểm kép về độ bao phủ và định vị: điểm độ bao phủ bằng chứng C.G. thống kê mỗi đoạn bằng chứng do con người gán nhãn có giao với bất kỳ khoảng dự đoán nào trong thời lượng dương hay không, đo lường việc có tìm thấy bằng chứng hay chưa; điểm định vị điểm nghẽn B.G. lấy hợp của toàn bộ khoảng dự đoán và khoảng gán nhãn trong từng phương thức, tính mức độ trùng khớp bằng IoU theo thời gian, sau đó lấy IoU thấp hơn giữa âm thanh và video làm điểm cuối. Cả hai chỉ số đều được nhân với điểm độ chính xác của câu trả lời, trả lời sai sẽ nhận 0 điểm; thiết kế này khiến dự đoán rộng chỉ có thể nhận điểm bao phủ, còn chỉ ranh giới chính xác mới đóng góp điểm định vị. Đồng thời, việc dùng “phương thức yếu” để chấm điểm ngăn mô hình dùng phương thức mạnh bù đắp cho phương thức yếu.
Thiết kế phân tầng năng lực thành ba cấp: tập dữ liệu được tổ chức theo độ phức tạp của suy luận và bằng chứng thành ba cấp. Level 1: truy xuất và định vị, kiểm tra khả năng căn chỉnh thời gian, sự kiện và thực thể giữa âm thanh và video; Level 2: hiểu cơ bản, yêu cầu kết hợp các manh mối nghe nhìn bổ trợ để hiểu sự kiện, cảm xúc và ý định; Level 3: suy luận phức tạp, yêu cầu tổng hợp nhiều bằng chứng phân tán ở các thời điểm khác nhau để hoàn thành phán đoán nhiều bước. Cấp độ càng cao, số lượng bằng chứng và thời lượng bao phủ trong mỗi câu hỏi càng tăng đáng kể, qua đó xác định điểm yếu của mô hình trong truy xuất, hiểu và suy luận nhiều bước dài hạn ở từng cấp độ cụ thể.
04Cách sử dụng EvaOmni
Cài đặt ứng dụng khách ModelScope: chạy pip install -U modelscope để cài đặt hoặc nâng cấp SDK ModelScope.
Tải tập dữ liệu: sử dụng dataset_snapshot_download với ID tập dữ liệu VisionXLab/EvaOmni-Dataset để tải dữ liệu về thư mục cục bộ.
Chuẩn bị đầu vào cho mô hình: tiền xử lý video theo giao thức đánh giá và chuẩn bị nội dung âm thanh đi kèm.
Tích hợp mô hình cần đánh giá: làm theo hướng dẫn trong kho GitHub để tích hợp mô hình đa phương thức của bạn, sử dụng lời nhắc thống nhất để mô hình xuất ra bộ ba gồm lựa chọn, dấu thời gian âm thanh và dấu thời gian video.
Chạy đánh giá: gọi khung đánh giá để suy luận hàng loạt trên toàn bộ 1.027 câu hỏi-trả lời; chương trình sẽ tự động kiểm tra câu trả lời và độ khớp của các khoảng thời gian.
Xem kết quả: đọc ba chỉ số Acc., C.G., B.G. cùng điểm số theo ba cấp năng lực, rồi so sánh với bảng xếp hạng để xác định điểm yếu của mô hình.
05Ưu thế cốt lõi của EvaOmni
Đưa định vị bằng chứng vào chấm điểm: yêu cầu mô hình trả về các khoảng thời gian bằng chứng âm thanh và video, phân biệt giữa đoán đúng và trả lời có căn cứ.
Định lượng chất lượng bằng chứng bằng hai chỉ số: điểm độ bao phủ bằng chứng C.G. đo lường việc có tìm đủ manh mối hay không; điểm định vị điểm nghẽn B.G. lấy phương thức yếu hơn theo IoU thời gian để chấm điểm, ngăn phương thức mạnh che giấu phương thức yếu.
Phân tầng năng lực thành ba cấp chi tiết: tiến dần từ truy xuất và định vị, hiểu cơ bản đến suy luận nhiều bước phức tạp, giúp xác định điểm yếu cụ thể của mô hình ở các độ sâu suy luận khác nhau.
Chất lượng gán nhãn thủ công cao: dữ liệu trải qua biên soạn câu hỏi bởi chuyên gia, kiểm duyệt chéo và xem xét lại các mẫu gây tranh cãi bởi hai chuyên gia, có độ tin cậy cao hơn các tiêu chuẩn tương tự được xây dựng tự động.
Cơ chế lọc lối tắt nghiêm ngặt: dùng ba loại đầu vào đơn phương thức gồm văn bản, âm thanh và hình ảnh để sàng lọc câu hỏi, loại bỏ các mẫu có thể trả lời đúng mà không cần suy luận kết hợp nghe nhìn, bảo đảm tính công bằng của đánh giá.
Phơi bày khoảng cách năng lực thực tế: kiểm thử cho thấy độ chính xác câu trả lời của mô hình mạnh nhất chỉ kém con người 17 điểm phần trăm, nhưng khả năng định vị hai phương thức lại kém 59.2 điểm phần trăm, cho thấy điểm yếu thực sự của các mô hình hiện nay.
06Địa chỉ dự án EvaOmni
Trang web dự án: https://xiaoxing2001.github.io/EvaOmni.github.io/
Kho GitHub: https://github.com/VisionXLab/EvaOmni
Kho mô hình HuggingFace: https://huggingface.co/datasets/VisionXLab/EvaOmni-Dataset
Bài báo kỹ thuật arXiv: https://arxiv.org/pdf/2610.28444
07Các kịch bản ứng dụng của EvaOmni
Nghiên cứu và đánh giá mô hình đa phương thức toàn diện: khi lặp lại và cải tiến Omni LLM, nhóm phát triển sử dụng ba chỉ số Acc./C.G./B.G. để xác định khoảng cách năng lực “câu trả lời được cải thiện nhưng khả năng định vị bằng chứng chưa theo kịp”, từ đó định hướng cải tiến huấn luyện.
Đánh giá và nghiệm thu lựa chọn AI cấp doanh nghiệp: trong các lĩnh vực như tài chính và chính quyền, nơi mô hình cần “đưa ra căn cứ có thể kiểm tra”, bên mua có thể dùng điểm định vị điểm nghẽn B.G. để sàng lọc các mô hình thực sự đáng tin cậy ở cả hai phương thức.
Kiểm duyệt và truy xuất nguồn gốc nội dung video: các ứng dụng kiểm duyệt yêu cầu mô hình chỉ ra nội dung vi phạm xuất hiện “ở khung hình nào, trong đoạn âm thanh nào”. Đầu ra khoảng thời gian và các chỉ số định vị của EvaOmni có thể được dùng trực tiếp làm tiêu chuẩn nghiệm thu.
Sản phẩm hỏi-đáp về nội dung giáo dục và điện ảnh: trợ lý học tập có video và sản phẩm thuyết minh phim cần trích dẫn đoạn phim gốc khi trả lời, có thể dùng tiêu chuẩn này để đánh giá liệu mô hình có định vị chính xác cảnh quay và lời thoại liên quan hay không.
Nghiên cứu học thuật và xây dựng bảng xếp hạng: nhà nghiên cứu có thể dựa trên 392 video mã nguồn mở có gán nhãn bằng chứng để nghiên cứu sâu hơn về suy luận nghe nhìn, định vị thời gian, suy luận nhiều bước và các hướng khác, hoặc đưa chúng vào hệ thống đánh giá kết hợp nhiều tiêu chuẩn.
© Tuyên bố miễn trừ trách nhiệm: tên miền và nội dung được liên kết có thể thay đổi theo thời gian. AIEZZ không kiểm soát các trang web của bên thứ ba. Hãy tự đánh giá nội dung bên ngoài và các rủi ro liên quan.
Đánh giá của người dùng0