
- Lượt truy cập hàng tháng
- 0
- Giá
- Chưa đặt
- Được liệt kê
- —
- Đã cập nhật
- 2026-11-02
01Xiaomi-OCR-0 là gì
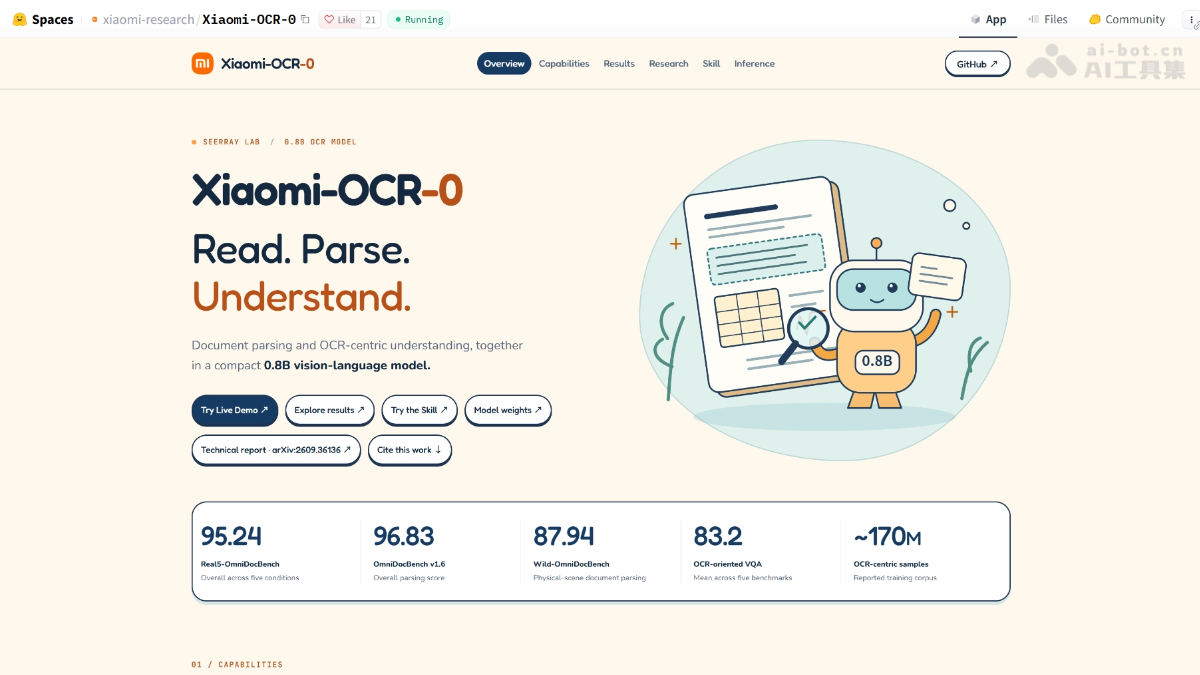
Xiaomi-OCR-0 là mô hình hiểu tài liệu đa phương thức nhẹ 0,8B do Xiaomi mã nguồn mở, được huấn luyện trên Qwen3.5-0.8B, tích hợp phân tích tài liệu, trích xuất thông tin chính và hỏi đáp trực quan OCR. Mô hình đứng đầu Real5-OmniDocBench với 95.24 điểm, xếp thứ hai tại OmniDocBench v1.6 với 96.83 điểm, đồng thời vượt qua các mô hình cùng cấp với điểm trung bình 83.2 trên cả năm bài kiểm tra OCR-VQA. Công cụ dữ liệu của Xiaomi-OCR-0 sử dụng gán nhãn đồng thuận chuyên gia và kiểm tra kết quả kết xuất, đi kèm chuỗi công cụ MCP và Agent Skill, đã được triển khai trên điện thoại Xiaomi trong tính năng “Tiểu Ái siêu cấp”.
02Các chức năng chính của Xiaomi-OCR-0
Phân tích tài liệu: nhận diện và khôi phục nội dung chính, bảng phức tạp và công thức toán học trong tài liệu, xuất kết quả có cấu trúc Markdown/LaTeX theo thứ tự đọc tự nhiên.
Trích xuất thông tin chính (KIE): định vị chính xác các trường được chỉ định và xuất dữ liệu có cấu trúc JSON cho các tài liệu bán cấu trúc như hóa đơn, thẻ và giấy tờ.
Hỏi đáp trực quan OCR: vượt ra ngoài việc chuyển đổi văn bản, hỗ trợ tìm kiếm xuyên thành phần, tính toán giá trị và hỏi đáp suy luận ngữ nghĩa trên tài liệu, biểu đồ.
03Nguyên lý kỹ thuật của Xiaomi-OCR-0
Theo dõi WeChat và trả lời “开源” để tham gia nhóm trao đổi dự án AI mã nguồn mở
Gán nhãn đồng thuận chuyên gia dị thể (ETC): 8 mô hình chuyên gia OCR khác nhau về kiến trúc, dữ liệu và chiến lược sẽ dự đoán độc lập các vùng tài liệu. Mức độ nhất quán từng cặp được tính riêng cho văn bản (NED), bảng (TEDS) và công thức (CDM), sau đó chọn bộ ba có mức đồng thuận cao nhất và lấy mode trung vị làm nhãn giả; chỉ các mẫu có độ đồng thuận ≥0.9 mới được đưa trực tiếp vào tập huấn luyện, loại bỏ thiên kiến của một mô hình đơn lẻ ngay từ đầu.
Kiểm tra tinh chỉnh có hướng dẫn bằng kết xuất (Render-Guided Refine-and-Judge): với các vùng có ý kiến chuyên gia không đồng nhất, Qwen3.5-122B-A10B sẽ kết xuất lại kết quả phân tích ứng viên thành hình ảnh, rồi so sánh với vùng gốc ở cấp độ pixel và cấu trúc để xác định các lỗi khó nhận biết như lệch hàng, lệch cột và thiếu ký hiệu, đồng thời lặp lại việc sửa tối đa 3 vòng; các trường hợp vẫn chưa hội tụ sẽ chuyển sang giai đoạn hai “chẩn đoán—sửa—xác minh” với đầy đủ lịch sử kiểm tra, cuối cùng phải quay lại nhóm chuyên gia để đạt đồng thuận mới được chấp nhận.
Khai thác mẫu và tổng hợp có định hướng: tỷ lệ dữ liệu huấn luyện được quyết định bởi ba tín hiệu kết hợp: mức độ đồng thuận của chuyên gia, tính nhất quán nội tại của mô hình và phân cụm ngữ nghĩa K-Means. Dựa trên đó, lần lượt xây dựng tập hỗn hợp phủ rộng cho CPT và tập mẫu khó cho RL; dữ liệu tổng hợp được tạo theo hai hướng “dựa trên độ phủ” và “dựa trên thất bại”, đồng thời chỉ chấp nhận công thức sau khi hiệu quả được xác minh trên tập kiểm thử cố định.
Huấn luyện tiến triển qua ba giai đoạn: trước tiên sử dụng tiền huấn luyện neo văn bản Q-Mask để thiết lập sự căn chỉnh chi tiết giữa nội dung văn bản và vị trí không gian; tiếp đó thực hiện tiền huấn luyện liên tục OCR đa nhiệm, mở rộng phạm vi các tác vụ như phân tích toàn trang, nhận diện vùng và VQA trong cùng một định dạng tự hồi quy; cuối cùng dùng học tăng cường Mix-RL theo kiểu DAPO trên các mẫu khó đã khai thác, định tuyến phần thưởng theo loại tác vụ và sử dụng phần thưởng có thể kiểm chứng để vượt qua giới hạn về bố cục phức tạp và suy luận nhiều bước.
04Cách sử dụng Xiaomi-OCR-0
Lấy mã nguồn: sao chép kho GitHub SeerRay-Lab/Xiaomi-OCR-0 và cài đặt môi trường phụ thuộc trong requirements.
Tải trọng số: tải các tệp trọng số mô hình 0.8B từ Hugging Face SeerRay-Lab/Xiaomi-OCR-0.
Trải nghiệm nhanh: chạy tập lệnh có sẵn của dự án để khởi động Demo tương tác trên trình duyệt, sau đó tải ảnh tài liệu lên để thử phân tích, trích xuất và hỏi đáp trực tuyến.
Cấu hình gọi Agent: tích hợp dịch vụ MCP hoặc Agent Skill trong kho vào tác tử của bạn để triển khai quy trình tự động “nhận diện màn hình/tài liệu—trích xuất trường—thực hiện bước tiếp theo”.
Triển khai dịch vụ cục bộ: sử dụng SGLang hoặc vLLM để triển khai mô hình thành dịch vụ suy luận cục bộ, cho phép hệ thống nghiệp vụ gọi qua API.
Tích hợp phát hiện bố cục: khi sử dụng pipeline hai giai đoạn, trước tiên dùng PP-DocLayoutV3 để phát hiện các vùng văn bản/bảng/công thức, sau đó đưa từng vùng vào Xiaomi-OCR-0 để nhận diện và ghép thành kết quả cấp trang.
Soạn chỉ dẫn: xây dựng prompt theo định dạng thống nhất image–instruction–response, lần lượt chỉ định loại tác vụ phân tích, KIE hoặc VQA.
05Ưu thế cốt lõi của Xiaomi-OCR-0
Hiệu quả tham số vượt trội: chỉ với 0.8B tham số, mô hình đạt 96.83 điểm trên OmniDocBench v1.6; các mô hình chuyên dụng 0.8B–1.2B đã vượt toàn diện các mô hình ngôn ngữ lớn đa dụng như GPT-5.2 và Qwen3-VL-235B.
Khả năng chống chịu dữ liệu thực tế đứng đầu: đạt 95.24 điểm và đứng đầu Real5-OmniDocBench, dẫn đầu trong cả năm bối cảnh nhiễu gồm quét, giấy bị cong, chụp lại màn hình, ánh sáng không đồng đều và chụp nghiêng.
Tích hợp ba năng lực: phân tích tài liệu, trích xuất thông tin chính và hỏi đáp trực quan OCR được hợp nhất trong một mô hình duy nhất. Có thể chuyển đổi tác vụ thông qua giao diện chỉ dẫn dùng chung mà không cần kết hợp nhiều mô hình chuyên dụng.
Công cụ dữ liệu thay thế việc tăng số tham số: 170 triệu mẫu được tạo tự động thông qua bỏ phiếu đồng thuận chuyên gia, kiểm tra có hướng dẫn bằng kết xuất và tổng hợp dựa trên thất bại, dùng chất lượng dữ liệu để thay thế quy mô mô hình.
Học theo chương trình tạo chuyển giao tích cực: tín hiệu giám sát hiểu biết sau khi hoàn thiện khả năng phân tích sẽ phản hồi để cải thiện phân tích tối đa +0.64 điểm, tạo ra bước nâng cao kép về năng lực với mô hình nhẹ.
06Địa chỉ dự án Xiaomi-OCR-0
Trang chính thức: https://huggingface.co/spaces/xiaomi-research/Xiaomi-OCR-0
Kho GitHub: https://github.com/xiaomi-research/Xiaomi-OCR-0
Kho mô hình HuggingFace: https://huggingface.co/xiaomi-research/Xiaomi-OCR-0
Bài báo kỹ thuật arXiv: https://arxiv.org/pdf/2609.36136
07Các kịch bản ứng dụng của Xiaomi-OCR-0
Quản lý tức thời các mã dùng trong đời sống: nhận diện mã nhận đồ ăn giao tận nơi, mã nhận hàng, số thứ tự chờ và các thông tin có thời hạn khác để “đưa lên đảo”, giúp truy cập ngay khi cần.
Ghi chép chi tiêu và sắp xếp hóa đơn thông minh: trích xuất chỉ bằng một lần chạm số tiền, người bán, thời gian và danh mục từ chi tiết hóa đơn WeChat/Alipay, tự động tạo bản ghi chi tiêu.
Nhập dữ liệu có cấu trúc từ thẻ và chứng từ: chụp ảnh hoặc nhận diện màn hình để trích xuất các trường từ căn cước, thẻ ngân hàng, hóa đơn, hộ chiếu và các giấy tờ khác thành JSON, thay thế việc nhập và đối chiếu thủ công.
Tạo lịch thông minh: trích xuất thời gian và địa điểm từ thông báo nhóm chat, áp phích sự kiện, tự động tạo thẻ lịch và thêm vào lịch.
Liên kết thông tin di chuyển: trích xuất thông tin hành trình như số hiệu chuyến bay từ cuộc trò chuyện, tự động tra cứu tình trạng cất cánh và hạ cánh theo thời gian thực rồi gửi nhắc nhở.
© Tuyên bố miễn trừ trách nhiệm: tên miền và nội dung được liên kết có thể thay đổi theo thời gian. AIEZZ không kiểm soát các trang web của bên thứ ba. Hãy tự đánh giá nội dung bên ngoài và các rủi ro liên quan.
Đánh giá của người dùng0