
- 月間訪問数
- 0
- 料金
- 未設定
- 掲載日
- —
- 更新済み
- 2026-10-08
01VoxMemとは
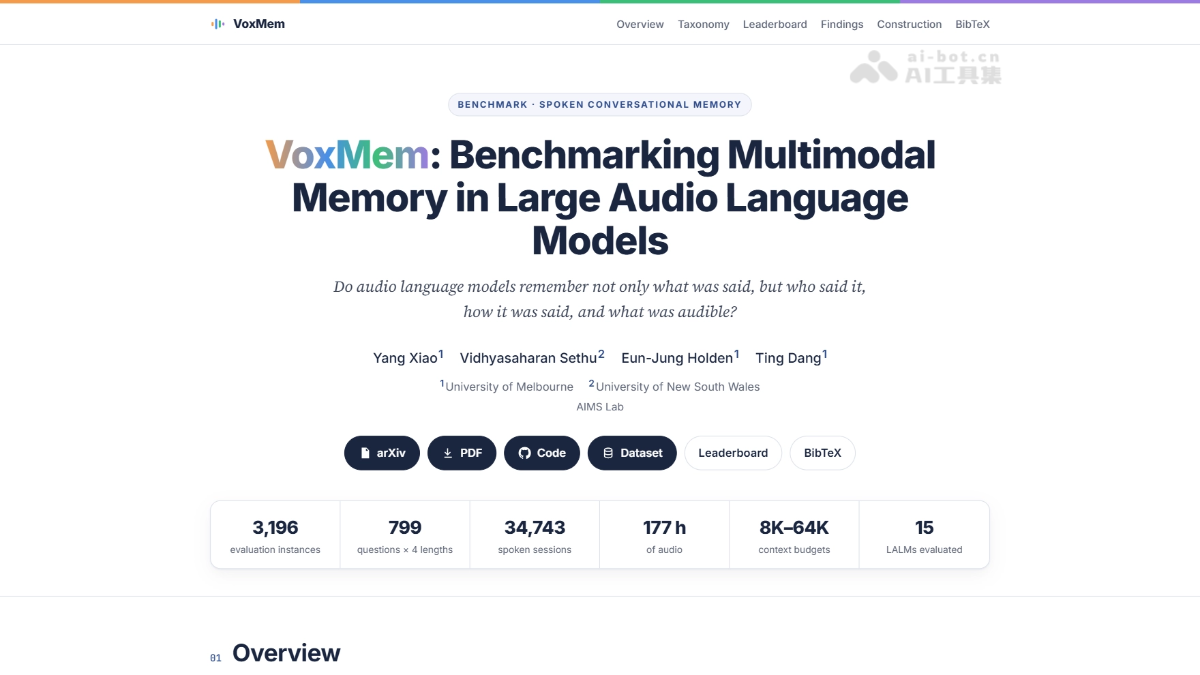
VoxMemは、メルボルン大学とニューサウスウェールズ大学のチームが開発した、音声大規模モデルの記憶ベンチマークです。意味、話者、話し方、環境音という4種類の音響証拠と、抽出、セッション横断推論、時系列追跡、回答拒否という4種類の記憶操作を組み合わせた、2次元評価フレームワークを初めて導入し、8Kから64Kトークンまでの複数セッション履歴をカバーします。15モデルをテストした結果、32Kでは全体正解率が40%を超えたモデルはなく、モデルは何が話されたかは記憶できても、誰がどのように話したかを記憶するのは困難でした。音声コンテキストを延長するだけでは、持続的な音声インタラクションを実現するには不十分です。
02VoxMemの主な機能
複数セッションの音声記憶評価:複数セッションかつ異なる長さの音声履歴において、大規模音声言語モデルが過去の対話内容を記憶し、想起できるかを体系的にテストします。
4種類の音響証拠をカバー:音声の意味、話者の身元、パラ言語的手がかり、環境音を同時に評価します。後者3つは文字起こしでは復元できない「音声固有」の情報です。
4種類の記憶操作による分類:情報抽出、複数セッション推論、時系列変化の追跡、証拠不足時の回答拒否をカバーし、相互に組み合わせて15個の有効な評価セルを構成します。
制御された履歴長:同じ問題について、8K/16K/32K/64Kトークンの4種類の履歴長で証拠を完全に一定に保ち、無関係なセッションだけを追加します。履歴長が記憶に与える影響を単独で切り分けられます。
オープンな評価体系:コードとデータをすべてオープンソースで公開し、標準化された実行・スコアリングスクリプトとLeaderboardを提供します。APIモデルとローカルモデルの再現実験に対応しています。
03VoxMemの技術原理
WeChatで「オープンソース」と返信すると、AIオープンソースプロジェクトの交流グループに参加できます。
2次元分類フレームワーク:VoxMemの中核設計は、音響証拠×記憶操作の2次元分類表です。音響証拠は何を記憶するかを示し、音声情報を意味、話者、パラ言語、環境音の4種類に分解します。記憶操作はどのように利用するかを示し、単一セッションから情報を取り出す(IE)、複数セッションにまたがって証拠を統合する(MSR)、時間順に状態の変化を追跡する(TET)、証拠不足時に回答を拒否する(AR)で構成されます。意味×IEの組み合わせは純粋なテキスト検索に退化するため意図的に除外し、残る15セルで完全な評価空間を構成します。これにより、音声記憶能力を断片的ではなく体系的に評価できます。
3段階のデータ構築:データ生成は「計画—対話作成—音声合成」のパイプラインで行います。まず各問題について、質問、回答、証拠の分布、有効性の制約を定めた構造化計画を生成します。次にユーザー側とアシスタント側の対話テキストをそれぞれ生成します。双方とも話者、話し方、背景音には言及せず、回答がテキストから漏れないようにします。最後にTTSで音声を合成し、各ユーザーの声質を固定し、スタイル制御によって話し方の手がかりを注入します。環境音は10dBの信号対雑音比で混合し、手がかりを含む各ターンについて、手がかりを除去したペア版も保存して品質検査に使用します。
干渉セッションと長さの制御:各履歴は、証拠セッション、干渉セッション、埋め込みセッションで構成されます。干渉セッションは証拠セッションと近い話題を扱いますが、値は異なります。テキストのみを使い、正解率がわずか51–56%の分類器による検証も組み合わせ、モデルが表面的な話題の一致だけで回答を見つけられないようにしています。長さの制御では、4つの長さの履歴を厳密に入れ子にし、無関係な埋め込みセッションだけで履歴を延長します。そのため、問題、回答、証拠は4つの長さで完全に同一となり、正解率の変化は履歴の長さだけに起因し、問題の難易度が混在する影響を排除できます。
04VoxMemの使い方
リポジトリをクローン:GitHubからコードを取得し、git clone https://github.com/swagshaw/voxmem を実行してプロジェクトディレクトリに移動します。
依存関係をインストール:pip install -r requirements.txt を実行します。音声を自動的に配列へデコードする場合は、任意で pip install "datasets" を実行します。
APIキーを設定:APIモデルを評価する場合は、対応するSDKをインストールしてキーを設定します。例:pip install openai の後に export OPENAI_API_KEY= を実行します。
スモークテストを実行:まず python run_voxmembench.py --config 8k_speaker_information --model abstain --allow-abstention --limit 25 --out predictions_smoke.jsonl を実行してフローを検証します。続いて score_voxmembench.py --judge exact-match でスコアを算出し、回答拒否層が拒否問題で1.0、回答可能な問題で0.0を得ることを確認します。
本評価を実行:設定(32k完全セットや32k_speaker_informationサブセットなど)と対象モデルを選択して実行します。例:python run_voxmembench.py --config 32k --model openai:gpt-4o-audio-preview --allow-abstention --out predictions_32k.jsonl。ローカルモデルでは、--adapter でカスタムアダプター関数を指定し、--model-dir で重みのディレクトリを指定します。
LLM審判によるスコアリング:python score_voxmembench.py --predictions predictions_32k.jsonl --judge openai:gpt-4o-mini --out metrics_32k.json を実行します。審判は問題、正解、回答のみを見て、自由形式の回答が同等かどうかを判定します。
05VoxMemの主な強み
音声固有の記憶を体系的にカバーする初のベンチマーク:語彙内容だけを評価する既存ベンチマークの限界を超え、誰が話したか、どのように話したか、何が聞こえたかといった非テキストの音響情報を初めて統一的な評価フレームワークに取り入れています。
厳密な2次元分類設計:4種類の音響証拠×4種類の記憶操作による15個の有効セルを用い、断片的な問題設定に代えて、音声記憶能力を包括的かつ直交的に分解して評価できます。
実環境に近い複数セッション設定:人間と機械の音声インタラクションで時間をまたいで行われる複数回のセッションを再現します。単一の長い独白ではなく、繰り返し登場する話者や状態更新に対するモデルの長期記憶を検証します。
長さの影響を完全に分離:同じ問題について、8Kから64Kまでの4種類の履歴長で証拠を厳密に入れ子にして一定に保ち、初めて「履歴が長くなる」影響を問題の難易度や証拠の種類から明確に分離します。
漏洩を防ぐ構築と二重の品質検査:対話の双方が音響的手がかりに言及せず、ペア版による比較と2段階の品質検査によって、文字起こしだけで回答できる問題を除外します。問題が本当に「読む」のではなく「聞く」ことを必要とするように設計されています。
抜け道を防ぐ干渉設計:話題は近いものの値が異なる干渉セッションに、正解率がわずか51–56%のテキスト分類器による検証を組み合わせ、キーワードの一致だけで回答を探す近道を防ぎます。
06VoxMemのプロジェクトURL
プロジェクト公式サイト:https://swagshaw.github.io/voxmem/
GitHubリポジトリ:https://github.com/swagshaw/voxmem
HuggingFaceモデルリポジトリ:https://huggingface.co/datasets/AudioMemory/voxmembench
arXiv技術論文:https://arxiv.org/pdf/2609.32607
07VoxMemの利用シーン
音声アシスタント/スマートスピーカーの長期記憶能力の選定:メーカーはVoxMemを使って、候補モデルがセッションをまたいでユーザーの好み、家族の声、過去の約束を記憶できるかを統一的にテストできます。導入後に「先週話したことをすぐ忘れる」事態を防げます。
車載・ウェアラブル音声インタラクションの評価:車内は環境音が大きく、ユーザーの話し方も変化します。VoxMemの環境音とパラ言語的手がかりの評価軸により、実際のノイズ環境でのモデルの記憶の信頼性を検証できます。
複数話者のカスタマーサービス・会議システムの品質検査:コンタクトセンターや会議議事録などの場面では、「どの発言を誰がしたか」を正しく紐づける必要があります。VoxMemの話者紐づけ・誤帰属評価は、このようなシステムの取り違え問題を直接診断するために利用できます。
コンパニオンロボット・高齢者支援製品の感情記憶検証:高齢者が先週ため息交じりに話したことや、話し方に表れる疲労感を担えるのはパラ言語的手がかりだけです。VoxMemの時系列追跡評価により、製品が時間の経過に伴う状態の変化を察知できるかを検証できます。
© 免責事項:ドメインやリンク先のコンテンツは時間の経過とともに変更される場合があります。AIEZZは第三者のウェブサイトを管理していません。外部コンテンツとリスクはご自身で確認してください。
ユーザーレビュー0