
- 月間訪問数
- 0
- 料金
- 未設定
- 掲載日
- —
- 更新済み
- 2026-09-15
01UnifoLM-WLA-1.0とは
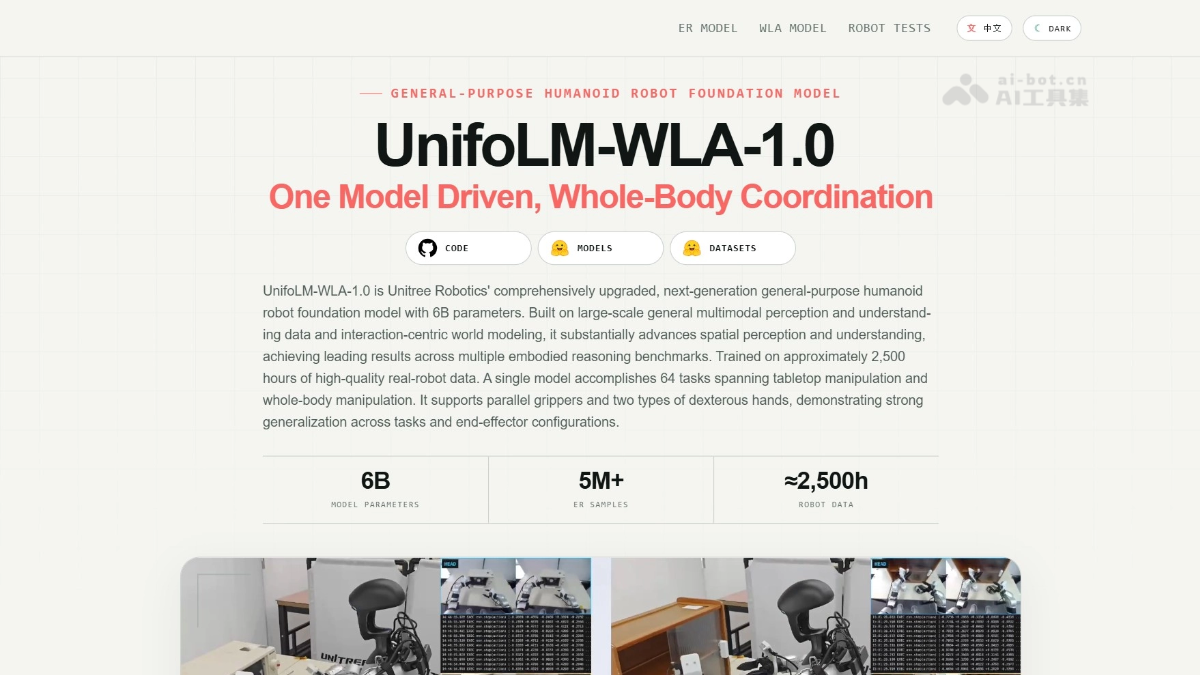
UnifoLM-WLA-1.0は、宇樹科技が開発した6B規模の具身マルチモーダル大規模モデルです。約2,500時間の実機データを用いて学習し、視覚・言語・動作を統一的にモデル化しています。1つのモデルで、デスクトップ操作と全身移動操作を含む64項目のタスクを統合的に処理します。約4B規模のUnifoLM-ER-1知覚・推論モデルと、ER-Flow動作モデリングモデルの重みをオープンソース化しています。後者は未来の動態予測と離散動作学習を融合したもので、完全なシステムとポストトレーニングコードも順次公開される予定です。
02UnifoLM-WLA-1.0の主な機能
具身知覚と推論:物体の位置、空間関係、操作可能な領域を認識し、「対象はどこにあるか」「物体同士にはどのような関係があるか」といった質問に回答します。操作判断に必要な知覚基盤を提供します。
視覚・言語・動作の統合実行:タスク指示をロボットが実行可能な動作へ直接変換します。1つのモデルで54項目のデスクトップタスクと10項目の全身移動操作を処理でき、タスクごとに個別の方策を学習する必要がありません。
インタラクション結果の予測:動作実行前に、操作によって生じるシーンの変化を予測し、無効な試行を減らします。
全身協調操作:上肢操作と下肢移動を含む全身制御に対応し、ベッドメイキング、衣類の折りたたみ、ゴミ捨てなど、移動と操作の連携が必要な複合タスクを実行できます。
03UnifoLM-WLA-1.0の技術原理
WeChatでフォローして「开源」と返信すると、AIオープンソースプロジェクト交流グループに参加できます。
統一VLAアーキテクチャ:視覚言語モデルを基盤とし、画像、言語指示、動作を同一モデル内で統合的にモデル化します。約2,500時間の実機データでエンドツーエンド学習を行い、6Bパラメータモデルを構築することで、知覚・計画・制御を分割した場合に生じる誤差の蓄積を回避します。
離散動作表現:RVQにより統一動作空間を構成し、エンドエフェクタの姿勢、器用なハンドの関節、下肢関節をそれぞれ動作トークンへ離散化します。これにより、連続制御の問題を、言語モデルが得意とするトークン予測問題へ変換し、視覚・テキスト情報と同一の系列内で処理します。
未来動態予測(ER-Flow層):マスクトークン機構を導入し、推論時に動作トークンと未来の動態領域トークンを同時に予測します。モデルは「動作する前」に、操作によって生じるシーンの変化を想像し、それに基づいて動作系列を生成することで、知覚と行動を密接に結合します。
階層型モデル設計:ER-1が低層の知覚・推論を担当し、ER-Flowがその上に動作モデリングを追加します。両者はWLAシステムの知覚基盤と中間層を構成し、完全な6Bシステムはその上でポストトレーニングを行い、全身操作能力を獲得します。
04UnifoLM-WLA-1.0の使い方
コードの取得:プロジェクトホームページ unigen-x.github.io/unifolm-wla.github.io またはGitHubリポジトリ unitreerobotics/unifolm-wla にアクセスし、READMEに従ってコードをクローンし、依存環境をインストールします。
重みのダウンロード:HuggingFaceから公開済みのUnifoLM-ER-1とUnifoLM-ER-Flowの2種類のモデル重みを取得します。huggingface-cli downloadコマンドを使用できます。
推論例の実行:まずプロジェクト提供の推論スクリプトでER-1を読み込み、ロボットの現在の映像とタスク説明を入力します。対象の位置特定や空間関係の理解など、知覚・推論の出力が正常かを確認します。
動作予測の接続:ER-Flowを読み込み、現在の画像、タスク指示、候補動作を入力します。モデルは離散動作トークンと未来の動態領域予測を出力するため、公式提供のRVQデコード方式に従って連続制御信号へ復元します。
実機制御への適用:デコードした動作指示を宇樹G1 / H1などのロボットの運動制御インターフェースに接続します。重み自体には完全なロボット制御システムが含まれていないため、シミュレーションまたは実機で小規模な検証を行ってから展開してください。
05UnifoLM-WLA-1.0の主な強み
1つのモデルで多タスクに対応:6Bパラメータで、54項目のデスクトップ操作と10項目の全身移動操作、計64項目のタスクを統合的に処理します。タスクごとに個別の方策を学習する必要がなく、高い汎化性能を実現します。
充実した実機データ:純粋なシミュレーションデータではなく、約2,500時間の実機操作データで学習しているため、出力動作が実際のロボットの力学特性により適合します。
高性能な知覚基盤:低層のER-1モデルはQwen3-VL-4Bを基盤とし、500万以上のサンプルで強化学習されています。RefSpatial-Benchをはじめとする7つのオープンソースモデル評価で、いずれも1位を獲得しました。
「予測」してから行動:ER-Flowは、操作によって生じる未来のシーン変化をマスクトークンで予測します。動作の結果を先に想像してから実行することで、無効な試行や衝突のリスクを減らします。
全身の統一制御:RVQにより、器用なハンド、エンドエフェクタの姿勢、下肢関節を統一動作トークンにエンコードし、同一モデル上で上肢操作と下肢移動の協調判断を実現します。
06UnifoLM-WLA-1.0のプロジェクトURL
プロジェクト公式サイト:https://unigen-x.github.io/unifolm-wla.github.io/
GitHubリポジトリ:https://github.com/unitreerobotics/unifolm-wla
HuggingFaceモデルリポジトリ: https://huggingface.co/unitreerobotics/UnifoLM-ER-Flow
https://huggingface.co/unitreerobotics/UnifoLM-ER-1
07UnifoLM-WLA-1.0の利用シーン
家庭向けサービス:衣類の折りたたみ、ベッドメイキング、ゴミ捨てなどの日常家事を実行します。発表会で重点的に実演された中核的な利用シーンです。
産業製造:生産ラインでの部品の把持、工具の受け渡し、簡単な組み立てなど、反復的な操作タスクを実行します。
物流・倉庫:商品の仕分け、荷物の運搬、棚の整理など、移動と操作の連携が必要な倉庫作業を行います。
研究・教育:完全オープンソースのエンドツーエンドVLA基盤として、大学や研究室で具身知能アルゴリズムの研究や、具身推論データの学習に利用できます。
商業施設での案内・サービス:展示ホールやショッピングモールなどで、案内や物品の受け渡しといった人と関わるサービス型タスクを実行します。
© 免責事項:ドメインやリンク先のコンテンツは時間の経過とともに変更される場合があります。AIEZZは第三者のウェブサイトを管理していません。外部コンテンツとリスクはご自身で確認してください。
ユーザーレビュー0