
- 月間訪問数
- 0
- 料金
- 未設定
- 掲載日
- —
- 更新済み
- 2026-10-16
01MiDashengLM-Spatialとは
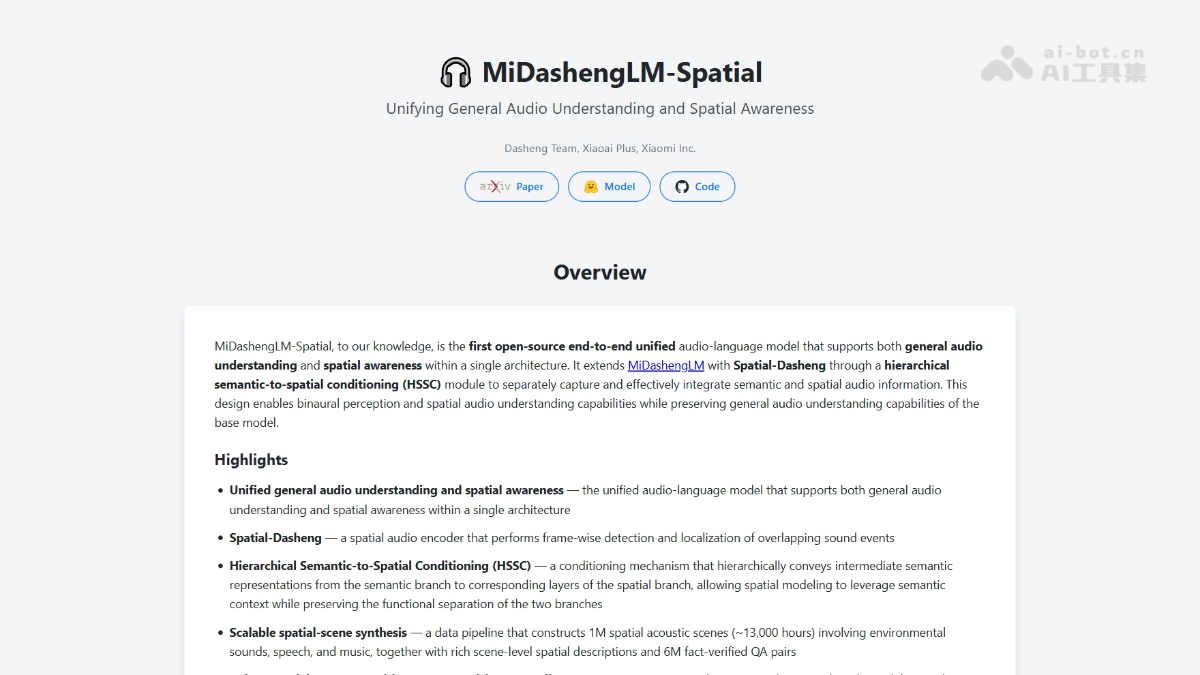
MiDashengLM-Spatialは、XiaomiのDashengチームがオープンソースで公開した空間音声理解のための大規模モデルです。単一アーキテクチャ内で汎用音声理解と空間認識を統合した、業界初のエンドツーエンドモデルです。MiDashengLM-SpatialはMiDashengLM-7Bをベースに、Spatial-Dashengエンコーダーと階層型セマンティクス・空間条件付けモジュールを追加しています。音源の方向、移動軌跡、複数音源の時空間関係を認識でき、重なり合う音源のフレーム単位の定位にも対応します。100万件の空間シーンと600万件のQA訓練データを備え、Apache 2.0ライセンスで公開されており、スマートホームや自動車コックピットへの応用が想定されています。
02MiDashengLM-Spatialの主な機能
音源定位:音が左側、右側、正面のどこから聞こえているかを判断します。
移動軌跡の認識:音源が空間内を移動する方向と経路を認識します。
複数音源の時空間関係推論:複数の音源間における相対的な空間位置関係を推論します。例えば、どちらがより左側にいるか、同じ側にいるかなどを判断します。
空間コンテンツ理解:「何が聞こえたか」と「音がどこから聞こえたか」を組み合わせて質問に回答します。例えば、どの話者が先に注文したかを判断します。
空間音声記述:シーン内に存在するすべての音源の位置、動き、時間関係を含む詳細な説明をオープン形式で生成します。
空間音声認識:話者の発話順に内容を書き起こし、各話者の方向を付記します。
03MiDashengLM-Spatialの技術原理
WeChatで公式アカウントをフォローし、「オープンソース」と返信して、AIオープンソースプロジェクトの交流グループに参加できます。
統合デュアルブランチアーキテクチャ:MiDashengLM-7BをベースにSpatial-Dasheng空間音声エンコーダーを拡張し、意味ブランチと空間ブランチが並列する構造を形成しています。それぞれ内容の理解と方向の認識を担い、単一モデル内で汎用音声理解と空間認識を同時に実現します。
Spatial-Dashengエンコーダー:バイノーラル入力を基に、重なり合う音源をフレーム単位で検出・定位します。ITD/ILDなどの両耳手掛かりを捉え、音源の方向と移動軌跡をきめ細かく空間モデル化します。
階層型セマンティクス・空間条件付け(HSSC):意味ブランチの中間層の表現を空間ブランチの対応する層へ段階的に伝達する条件付け機構です。これにより、空間モデル化が意味コンテキストを活用しながら、両ブランチの機能的な独立性を維持できます。
拡張可能な空間シーンデータパイプライン:シミュレーションにより100万件の空間音響シーンを構築し、環境音、音声、音楽を網羅します。シーンレベルの空間記述と600万件の事実検証用QAペアを自動生成し、空間能力の大規模訓練を支えます。
Sim-to-Real汎化:合成データで訓練したモデルは、実際のバイノーラル録音に対しても堅牢な空間認識能力を示します。また、空間能力を獲得しながら、ベースモデルの汎用音声理解性能を損ないません。
04MiDashengLM-Spatialの使い方
コードリポジトリをクローンします:git clone https://github.com/xiaomi-research/midashenglm-spatial.git。
推論環境を作成して依存関係をインストールします:conda create -n midashengspatial python=3.13 -y && conda activate midashengspatial、その後 pip install -r requirements.txt を実行します。
モデルの重みを取得します:個別にダウンロードする必要はありません。コードがHuggingFaceから mispeech/midashenglm-spatial を自動取得します。
バイノーラル音声を準備します:(2, T)形式の2チャンネル実バイノーラル音声を入力します。
モデルとプロセッサを読み込みます:AutoModelForCausalLMとAutoProcessorを使用し、trust_remote_code=Trueを指定してモデルを読み込みます。
対話メッセージを構成します:「音声を先、テキストを後」にする訓練時の順序でmessagesを構成します。例えば、音声と「Write a general audio caption describing the sound source and its spatial information.」を組み合わせます。
推論を実行します:processor.apply_chat_templateで入力を処理した後、model.generateを呼び出し、batch_decodeで結果を出力します。
サンプルを実行します:リポジトリのexample/inference.pyに、そのまま実行できる完全なサンプルがあります。
05MiDashengLM-Spatialの主な強み
業界初:単一アーキテクチャ内で汎用音声理解と空間認識を同時にサポートする、初のオープンソース・エンドツーエンド音声言語統合モデルです。
トップクラスの空間認識能力:STAR-Benchの空間推論サブセットで正解率70.3%を達成し、人間の73.7%に近い性能を示しています。Gemini-3.6-Flashの47.0%を大きく上回ります。
信頼性の高い認識:Channel-Swap ACRは72.6%に達し、左右方向の判断が実際の聴覚手掛かりに基づいていることを示しています。
汎用能力を維持:モノラル音声QA、音声認識、音声記述などの汎用ベンチマークで、ベースモデルMiDashengLM-7Bとほぼ同等の成績を示します。空間能力によって汎用性が損なわれることはありません。
重なり合う音源の解析:Spatial-Dashengエンコーダーは重なり合う音源のフレーム単位の検出・定位に対応し、現実のシーンで複数人が同時に話すような複雑な状況も処理できます。
06MiDashengLM-SpatialのプロジェクトURL
プロジェクト公式サイト:https://jinbo-hu.github.io/midashenglm-spatial-demo/
GitHubリポジトリ:https://github.com/xiaomi-research/midashenglm-spatial
HuggingFaceモデル:https://huggingface.co/mispeech/midashenglm-spatial
arXiv技術論文:https://arxiv.org/pdf/2610.11156
07MiDashengLM-Spatialの活用シーン
スマートコックピットのインタラクション:車内のどの座席の乗客が話しているかを判断し、ゾーン別の音声認識とコマンド実行を実現します。
スマートホームの音響認識:スピーカーやスマートホーム機器を通じて、家の中で発生する音の方向と移動を認識します。
AR/VR空間音声:仮想世界に聴覚面での空間理解を提供し、音源定位、空間記述の生成、没入型インタラクションを実現します。
補聴・アクセシビリティ機器:聴覚障害者が音の方向を把握できるよう支援し、環境認識と移動時の安全性を高めます。
© 免責事項:ドメインやリンク先のコンテンツは時間の経過とともに変更される場合があります。AIEZZは第三者のウェブサイトを管理していません。外部コンテンツとリスクはご自身で確認してください。
ユーザーレビュー0