
- Lượt truy cập hàng tháng
- 0
- Giá
- Chưa đặt
- Được liệt kê
- —
- Đã cập nhật
- 2026-09-14
01Xiaomi-CocktailASR-1 là gì
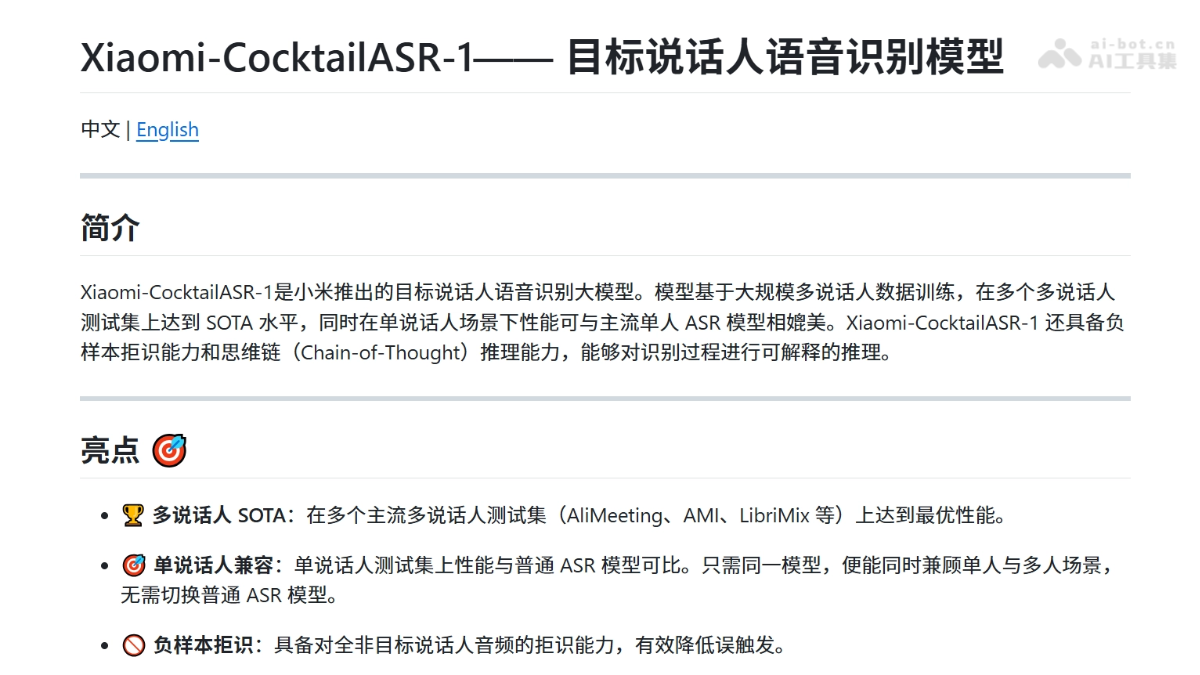
Xiaomi-CocktailASR-1 là mô hình nhận dạng giọng nói người nói mục tiêu quy mô lớn do Xiaomi mã nguồn mở, dựa trên kiến trúc LLM đầu cuối, sử dụng giọng nói tham chiếu làm gợi ý dấu giọng. Không cần tách giọng nói, mô hình có thể phiên âm chính xác người nói mục tiêu từ âm thanh trộn của nhiều người. Mô hình đạt mức SOTA trên các bộ tiêu chuẩn nhiều người nói, đồng thời tương thích với kịch bản một người nói, hỗ trợ từ chối mẫu âm thanh âm tính và khả năng suy luận có thể giải thích bằng chuỗi suy nghĩ, được phát hành theo giấy phép Apache 2.0.
02Các tính năng chính của Xiaomi-CocktailASR-1
Nhận dạng giọng nói người nói mục tiêu: Với giọng nói tham chiếu và âm thanh trộn của nhiều người, mô hình trực tiếp phiên âm nội dung của người nói mục tiêu mà không cần tách giọng nói.
Tương thích với một người nói: Cùng một mô hình có thể xử lý kịch bản một người, đạt hiệu năng tương đương các hệ thống ASR một người nói phổ biến mà không cần chuyển đổi mô hình.
Từ chối mẫu âm thanh âm tính: Khi người nói mục tiêu không xuất hiện trong âm thanh, mô hình xuất ra văn bản trống, giúp giảm hiệu quả các lần kích hoạt nhầm.
Suy luận bằng chuỗi suy nghĩ: Chế độ CoT xuất ra quá trình suy luận như số người nói, giới tính và độ tương đồng dấu giọng, cân bằng giữa khả năng giải thích và độ chính xác nhận dạng.
03Nguyên lý kỹ thuật của Xiaomi-CocktailASR-1
Kiến trúc hợp nhất đầu cuối: Mô hình gồm ba phần: bộ mã hóa âm thanh 0.6B được cải tiến dựa trên Data2Vec2, Adapter tuyến tính nhẹ và phần lõi mô hình ngôn ngữ lớn Qwen3-8B. Đầu vào được nối theo thứ tự «giọng nói tham chiếu + 1 giây im lặng + giọng nói trộn». Sau khi bộ mã hóa tạo đặc trưng ở cấp độ khung, Adapter căn chỉnh chúng vào không gian ẩn của LLM, rồi đưa cùng Prompt văn bản vào LLM để tạo bản phiên âm của người nói mục tiêu.
Giọng nói tham chiếu làm gợi ý điều kiện: Bộ mã hóa sử dụng cơ chế dự đoán mặt nạ tự giám sát của Data2Vec2 để hợp nhất thông tin ngữ nghĩa và thông tin người nói trong một mạng duy nhất, không cần bộ mã hóa dấu giọng độc lập. Giọng nói tham chiếu được xem như Prompt điều kiện, giúp bộ mã hóa tự thích nghi tập trung vào người nói mục tiêu và giảm ảnh hưởng của giọng nói gây nhiễu ngay trong giai đoạn trích xuất đặc trưng, từ đó tránh tích lũy sai số của hệ thống nối tiếp «tách + nhận dạng» truyền thống.
Huấn luyện đa giai đoạn cân bằng nhiều năng lực: Thông qua việc phối trộn dữ liệu khoảng một triệu giờ, mô hình được huấn luyện để thống nhất bốn năng lực: khoảng 400 nghìn giờ dữ liệu nhiều người nói dùng cho trích xuất mục tiêu; khoảng 600 nghìn giờ cặp tham chiếu-mục tiêu cùng người nói nhằm ngăn việc triệt tiêu quá mức trong kịch bản một người; khoảng 10 nghìn giờ mẫu âm thanh âm tính có giọng tham chiếu không khớp để hình thành năng lực từ chối mà không cần ngưỡng khi suy luận; ngoài ra, dữ liệu CoT dạy mô hình xuất chuỗi suy luận trước rồi mới đưa ra câu trả lời.
Prompt hai chế độ và cơ chế từ chối: Chế độ tiêu chuẩn sử dụng Prompt thống nhất để bao quát đồng thời ba loại tác vụ: nhận dạng một người, nhận dạng người mục tiêu trong nhiều người và từ chối mẫu âm thanh âm tính. Khi mục tiêu không xuất hiện, mô hình tự nhiên xuất ra văn bản trống; chế độ CoT sử dụng Prompt độc lập để kích hoạt nhãn suy luận, xuất các bước trung gian như số người nói, giới tính và độ tương đồng dấu giọng, sau đó đưa ra bản phiên âm cuối cùng, nâng cao khả năng giải thích và giảm nhẹ WER.
04Cách sử dụng Xiaomi-CocktailASR-1
Cài đặt phụ thuộc: Chạy pip install torch torchaudio transformers soundfile để cài đặt môi trường cần thiết.
Tải mô hình: Tải các tệp trọng số mô hình từ HuggingFace(Ease3/Xiaomi-CocktailASR-1).
Nạp mô hình: Nạp mô hình bằng AutoModel.from_pretrained("Ease3/Xiaomi-CocktailASR-1", trust_remote_code=True, torch_dtype="bfloat16").cuda().eval().
Chuẩn bị âm thanh: Chuẩn bị một đoạn giọng nói tham chiếu đơn kênh 16k (dấu giọng của người nói mục tiêu) và một đoạn âm thanh một người/nhiều người cần nhận dạng (âm thanh không phải 16k sẽ được tự động lấy mẫu lại).
Suy luận từng mẫu: Gọi model("target.wav", "ref_speaker.wav") để trả về văn bản phiên âm của người nói mục tiêu (với mẫu âm thanh âm tính, mô hình tự động xuất văn bản trống mà không cần tham số bổ sung).
Suy luận bằng chuỗi suy nghĩ: Thêm tham số cot=True, mô hình sẽ xuất quá trình suy luận trong và kết quả cuối cùng trong .
Suy luận hàng loạt: Sắp xếp dữ liệu thành TSV gồm 5 cột (utt_id, wav, text, ref_wav, ref_id), chạy tools/test_batch_scp.py và chỉ định đường dẫn mô hình, TSV đầu vào cùng tệp đầu ra để phiên âm hàng loạt.
05Ưu điểm cốt lõi của Xiaomi-CocktailASR-1
Hiệu năng SOTA trong môi trường nhiều người nói: Đạt mức nhận dạng tốt nhất trên nhiều bộ tiêu chuẩn nhiều người nói phổ biến như AliMeeting, AMI và LibriMix (ví dụ WER Far trên AliMeeting là 20.63%, trong khi SOTA trước đó là 27.5%).
Hợp nhất kịch bản một và nhiều người: Cùng một mô hình đạt hiệu năng tương đương các hệ thống ASR phổ biến trong kịch bản một người nói, không cần chuyển đổi mô hình theo số người nói.
Khả năng từ chối mẫu âm thanh âm tính: Khi người nói mục tiêu vắng mặt, mô hình xuất văn bản trống, tỷ lệ từ chối đạt 68%-80%, trong khi tỷ lệ này của Qwen3-ASR, StepAudio và các mô hình khác là 0.
Suy luận có thể giải thích bằng chuỗi suy nghĩ: Chế độ CoT xuất quá trình suy luận như số người nói, giới tính và độ tương đồng dấu giọng, vừa nâng cao khả năng giải thích vừa giúp giảm nhẹ WER.
Kiến trúc đầu cuối đơn giản: Giọng nói tham chiếu được dùng trực tiếp làm Prompt dấu giọng, loại bỏ mô-đun tách giọng nói truyền thống và tránh tích lũy sai số của hệ thống nối tiếp.
Ngưỡng sử dụng thấp: Gọi bằng một dòng mã, hỗ trợ tự động lấy mẫu lại và suy luận hàng loạt, cung cấp Demo mẫu dương tính và âm tính, sẵn sàng sử dụng.
06Địa chỉ dự án Xiaomi-CocktailASR-1
Kho GitHub:https://github.com/xiaomi-research/xiaomi-cocktailasr-1
Kho mô hình HuggingFace:https://huggingface.co/Ease3/Xiaomi-CocktailASR-1
Bài báo kỹ thuật arXiv:https://arxiv.org/pdf/2609.11274
07Các kịch bản ứng dụng của Xiaomi-CocktailASR-1
Phiên âm định hướng trong cuộc họp thông minh: Trong cuộc họp nhiều người, chỉ nghe và phiên âm nội dung của người phát biểu được chỉ định, tự động lọc lời xen ngang và thảo luận của những người tham dự khác.
Nhận dạng lệnh chính của trợ lý giọng nói: Trong các kịch bản điện thoại, loa và xe hơi, chỉ phản hồi giọng nói của chủ thiết bị, tránh để giọng nói của người khác trong nền vô tình kích hoạt lệnh.
Phân tích bản ghi chăm sóc khách hàng và kiểm tra chất lượng: Trích xuất chính xác toàn bộ lời thoại của một bên được chỉ định từ bản ghi cuộc gọi nhiều người, phục vụ kiểm tra tuân thủ và đánh giá dịch vụ.
Điều khiển nhà thông minh bằng giọng nói: Trong môi trường gia đình có tiếng TV ồn và nhiều người trò chuyện, nhận dạng chính xác lệnh giọng nói của người cầm điều khiển, tránh thao tác nhầm.
Thiết bị trợ thính và ghi chép hỗ trợ tiếp cận: Trích xuất có định hướng nội dung giọng nói của người nói cụ thể và chuyển thành văn bản theo thời gian thực cho người khiếm thính hoặc người ghi chép, giúp tập trung «nghe rõ» người mình muốn nghe trong môi trường giao tiếp ồn ào.
© Tuyên bố miễn trừ trách nhiệm: tên miền và nội dung được liên kết có thể thay đổi theo thời gian. AIEZZ không kiểm soát các trang web của bên thứ ba. Hãy tự đánh giá nội dung bên ngoài và các rủi ro liên quan.
Đánh giá của người dùng0