
Tất cả công cụ AI
Nhận diện giọng nói AI
Tổng hợp các sản phẩm AI nổi bật trong lĩnh vực nhận diện giọng nói, bao phủ các nhu cầu phổ biến như sáng tạo, xử lý và nâng cao hiệu suất.
 Spark-ASR-2.0Nhận diện giọng nói AISpark-ASR-2.0 là mô hình nhận dạng giọng nói thế hệ mới nhất của iFlytek, được phát triển dựa trên mô hình nền tảng giọng nói Spark-Audio thuộc hệ sinh thái Spark. Mô hình sử dụng kiến trúc phối hợp “phi tự hồi quy + tự hồi quy tăng cường bằng LLM”, hỗ trợ tiếng Trung và tiếng Anh kết hợp, phương ngữ, thuật ngữ chuyên ngành...00
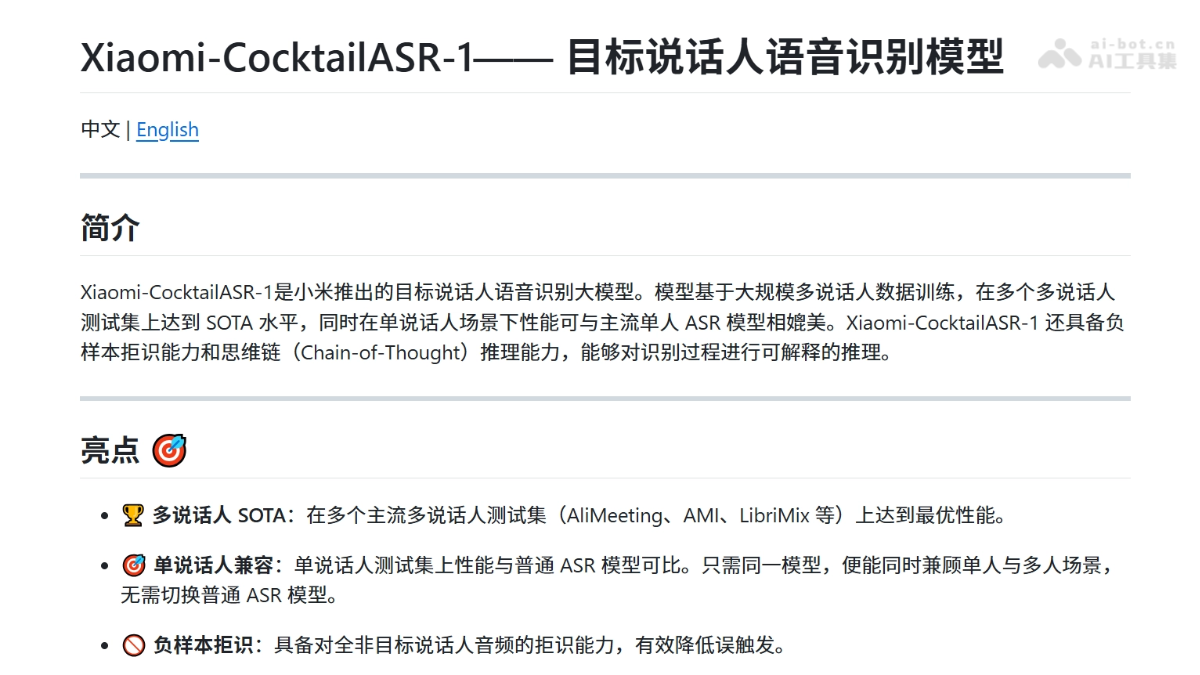 Xiaomi-CocktailASR-1Nhận diện giọng nói AIXiaomi-CocktailASR-1 là mô hình nhận dạng giọng nói người nói mục tiêu quy mô lớn do Xiaomi mã nguồn mở, dựa trên kiến trúc LLM đầu cuối, sử dụng giọng nói tham chiếu làm gợi ý dấu giọng. Không cần tách giọng nói, mô hình có thể phiên âm chính xác người nói mục tiêu từ âm thanh trộn của nhiều người...00
 MAI-Transcribe-2Nhận diện giọng nói AIMAI-Transcribe-2 là mô hình AI chuyển giọng nói thành văn bản mạnh mẽ nhất do Microsoft phát triển, dẫn đầu toàn diện về độ chính xác, tốc độ và chi phí. Mô hình hỗ trợ 60 ngôn ngữ, với tỷ lệ lỗi từ trung bình chỉ 5,2% trên bộ kiểm thử FLEURS.00
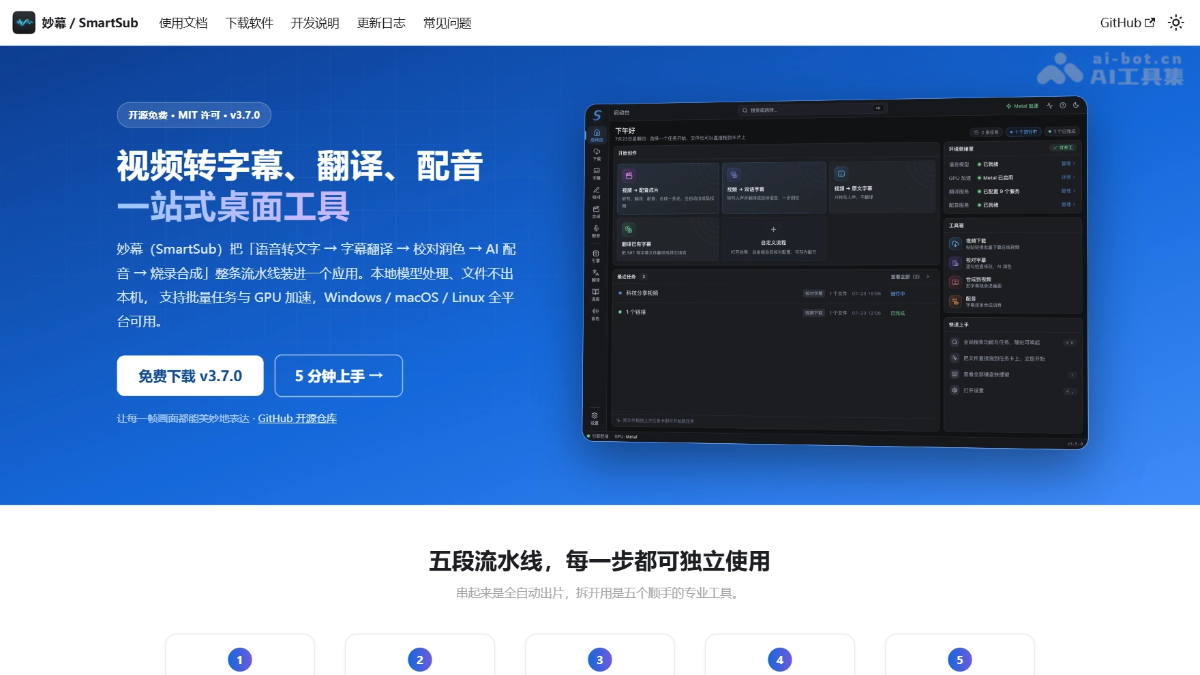 SmartSub – Công cụ desktop mã nguồn mở xử lý phụ đề âm thanh và video tất cả trong mộtNhận diện giọng nói AISmartSub (妙幕) là công cụ desktop mã nguồn mở xử lý phụ đề âm thanh và video tất cả trong một. Công cụ tích hợp toàn bộ quy trình trong một ứng dụng duy nhất, sử dụng các mô hình cục bộ như Whisper, FunASR và Qwen3-ASR để chuyển giọng nói thành văn bản ngoại tuyến, hỗ trợ hơn 20 dịch vụ dịch thuật và lồng tiếng AI đa vai. Tích hợp trình tải video trực tuyến, tương thích với các nền tảng như Bilibili và YouTube, hỗ trợ tăng tốc phần cứng NVIDIA CUDA, Apple Core ML cùng nhiều nền tảng khác, chạy cục bộ trên Windows, macOS và Linux.00
 Hy ASR 3.0 preview – Mô hình nhận dạng giọng nói thế hệ mới do Tencent Hunyuan ra mắtNhận diện giọng nói AIHy ASR 3.0 preview – Mô hình nhận dạng giọng nói thế hệ mới do Tencent Hunyuan ra mắt là hệ thống nhận dạng giọng nói thế hệ mới dựa trên mô hình ngôn ngữ lớn Hy3, kết hợp khả năng nhận dạng giọng nói độ chính xác cao với khả năng hiểu ngữ nghĩa sâu. Mô hình hỗ trợ tiếng Trung, tiếng Anh, tiếng Quảng Đông và 10 khu vực phương ngữ lớn, đồng thời có khả năng tự sửa lỗi thông minh theo ngữ cảnh, chèn từ khóa và hoạt động ổn định trong các bối cảnh phức tạp như môi trường nhiều tạp âm hoặc lời thì thầm. WER trên bộ đánh giá mã nguồn mở được kiểm soát ở mức khoảng 3%, còn trên bộ đánh giá tự xây dựng, mô hình vượt trội đối thủ trên mọi phương diện. Mô hình phù hợp với các tình huống như chăm sóc khách hàng thông minh, sáng tạo nội dung, tìm kiếm bằng giọng nói, cộng tác văn phòng và thiết bị đầu cuối thông minh. Người dùng có thể tích hợp qua API Tencent Cloud hoặc trải nghiệm miễn phí trong Tencent Yuanbao.00
Tất cả công cụ trong danh mục này được hiển thị.