
- Lượt truy cập hàng tháng
- 0
- Giá
- Chưa đặt
- Được liệt kê
- —
- Đã cập nhật
- 2026-09-24
01Qwen-Audio-3.1 là gì
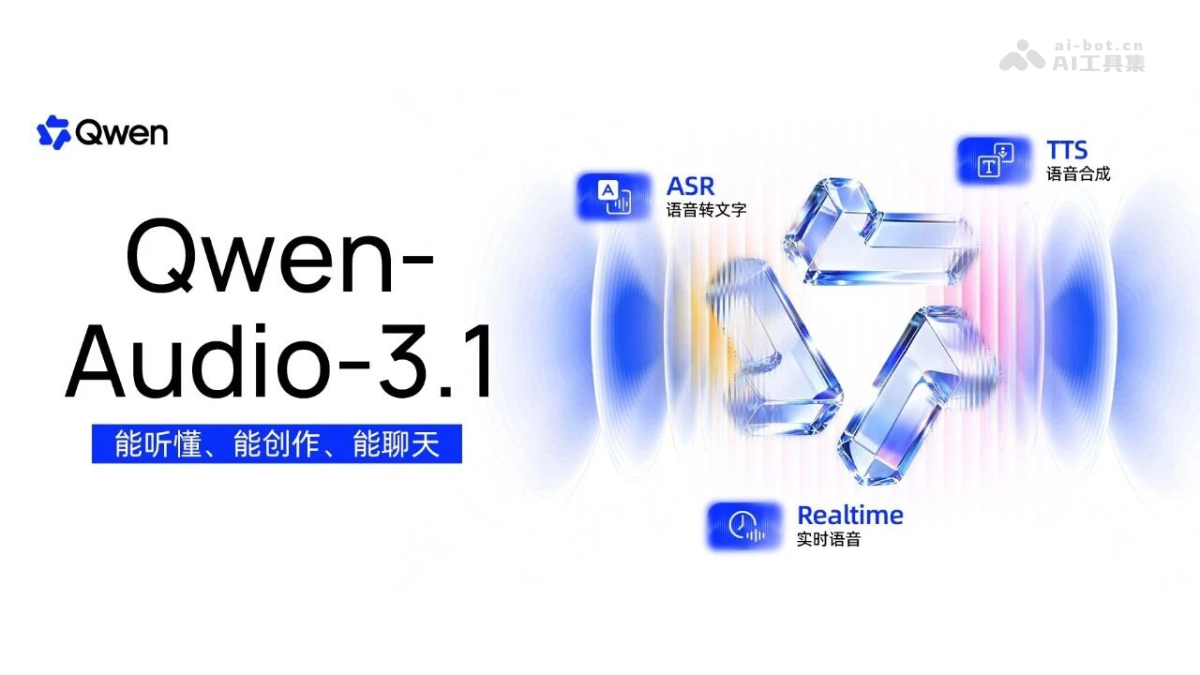
Qwen-Audio-3.1 là dòng mô hình ngôn ngữ lớn về giọng nói do Tongyi Qianwen phát triển, gồm năm mô hình: ASR nhận dạng giọng nói, ASR-Next hiểu âm thanh, TTS tổng hợp giọng nói, TTS-Next sáng tạo âm thanh và Realtime tương tác thời gian thực, bao phủ toàn bộ chuỗi từ hiểu - tạo sinh - tương tác - sáng tạo. Qwen-Audio-3.1 hỗ trợ 30 ngôn ngữ và 16 phương ngữ, chuyển lời theo từng người nói, nhận biết cảm xúc và đối thoại thời gian thực song công toàn phần, đồng thời có thể gọi công cụ để hoàn thành nhiệm vụ.
02Các tính năng chính của Qwen-Audio-3.1
ASR nhận dạng giọng nói: hỗ trợ chuyển lời theo từng người nói bằng 30 ngôn ngữ và 16 phương ngữ tiếng Trung, kèm nhãn người nói và dấu thời gian, đồng thời có thể tự nhiên biên tập văn bản.
ASR-Next hiểu âm thanh: mở rộng từ văn bản chuyển lời sang hiểu cảm xúc của con người, âm thanh môi trường và âm thanh máy móc, hỗ trợ mô tả âm thanh, định vị sự kiện và hỏi đáp về âm thanh.
TTS tổng hợp giọng nói: hỗ trợ tổng hợp đa ngôn ngữ, đa phương ngữ, chuyển đổi tự nhiên cùng một chất giọng giữa các ngôn ngữ và điều khiển cảm xúc, tốc độ nói bằng chỉ dẫn.
TTS-Next sáng tạo âm thanh: tạo một lần bản âm thanh hoàn chỉnh gồm giọng người, hiệu ứng âm thanh và âm thanh môi trường, phù hợp cho podcast, sách nói, phim ảnh, trò chơi và quảng cáo.
Realtime tương tác thời gian thực: nghe và nói đồng thời theo cơ chế song công toàn phần, hiểu cảm xúc và ý định, chuyển đổi đa ngôn ngữ, đồng thời có thể gọi công cụ để hoàn thành nhiệm vụ trong hội thoại.
03Nguyên lý kỹ thuật của Qwen-Audio-3.1
Mô hình hóa liên kết đầu-cuối (ASR): Qwen-Audio-3.1-ASR sử dụng phương pháp đầu-cuối, xuất đồng thời nhãn người nói, dấu thời gian và văn bản chuyển lời thay vì xử lý từng bước như hệ thống liên kết truyền thống, nhờ đó có thể giữ lại các đoạn chen lời ngắn và giọng nói chồng lấn; mô hình cũng tích hợp khả năng loại bỏ từ đệm, loại bỏ lặp, tự sửa lỗi và tái cấu trúc ngữ nghĩa, giúp kết quả chuyển lời có cấu trúc phù hợp để sử dụng trực tiếp cho biên bản cuộc họp và phân tích hội thoại.
Kiến trúc hiểu âm thanh thế hệ mới (ASR-Next): ASR-Next dựa trên kiến trúc thế hệ mới, mở rộng đối tượng xử lý từ “văn bản trong lời nói” thành tín hiệu âm thanh hoàn chỉnh. Thông qua việc hiểu cảm xúc, âm thanh môi trường và âm thanh máy móc ở tầng âm học, mô hình thực hiện định vị, mô tả và suy luận về sự kiện âm thanh, đánh dấu bước chuyển của ASR từ công cụ chuyển lời thành mô hình hiểu âm thanh tổng quát.
Chuyển đổi chất giọng và điều khiển biểu đạt (TTS): mô hình TTS vượt qua phương thức tổng hợp truyền thống vốn chỉ chú trọng phát âm chính xác, cho phép chuyển đổi tự nhiên giữa các ngôn ngữ và phương ngữ với cùng một chất giọng, đồng thời mô hình hóa cảm xúc, tốc độ nói và cách biểu đạt bằng chỉ dẫn để giọng nói tổng hợp phù hợp với nội dung và bối cảnh.
Tạo âm thanh thống nhất (TTS-Next): TTS-Next xoay quanh ba loại đầu vào gồm văn bản, dấu thời gian và âm thanh tham chiếu để tạo thống nhất giọng người, hiệu ứng âm thanh và âm thanh môi trường; duy trì sự nhất quán về chất giọng và cảm xúc của từng nhân vật trong nhiều lượt hội thoại, đồng thời điều khiển quá trình tạo bằng ngôn ngữ tự nhiên, hỗ trợ kiểm soát dấu thời gian chi tiết, sao chép giọng nói và đầu ra độ trung thực cao 48kHz.
Kiến trúc song công toàn phần chưng cất đa giáo viên (Realtime): Realtime sử dụng kiến trúc chưng cất đa giáo viên, nâng cao năng lực hiểu, suy luận, biểu đạt và an toàn trong khi vẫn duy trì độ trễ thấp, từ đó实现 tương tác song công toàn phần, nói và nghe diễn ra đồng thời, hỗ trợ chen lời và ngắt bất cứ lúc nào; mô hình tích hợp khả năng gọi công cụ, có thể hiểu nhu cầu thay đổi trong hội thoại liên tục, kết nối API bên ngoài, cơ sở tri thức và hệ thống nghiệp vụ để hoàn thành nhiệm vụ.
04Cách sử dụng Qwen-Audio-3.1
Mở nền tảng Qianwen AI: truy cập https://www.qianwenai.com/ và đăng nhập tài khoản, sau đó vào khu vực mô hình.
Chọn mô hình cần dùng: tùy theo nhu cầu, chọn mô hình tương ứng gồm ASR (chuyển lời), TTS (tổng hợp), TTS-Next (sáng tạo) hoặc Realtime (tương tác thời gian thực), rồi nhấp để vào trang chi tiết.
Lấy API Key: kích hoạt dịch vụ mô hình trong bảng điều khiển và tạo API Key để xác thực giao diện.
Gọi API: tham khảo tài liệu API trên trang chi tiết của từng mô hình và truyền tham số âm thanh hoặc văn bản qua yêu cầu HTTP (API ASR-Next chưa được phát hành, cần chờ mở quyền truy cập).
Tích hợp vào ứng dụng: kết nối API với ứng dụng, Agent hoặc thiết bị thông minh của bạn để thực hiện các tác vụ giọng nói trực tuyến.
05Ưu điểm cốt lõi của Qwen-Audio-3.1
Năng lực đa ngôn ngữ và phương ngữ mạnh: một bộ mô hình hỗ trợ 30 ngôn ngữ và 16 phương ngữ tiếng Trung, trong đó khả năng nhận dạng các phương ngữ khó nghe như tiếng Ôn Châu được cải thiện rõ rệt.
Biên tập thông minh khi chuyển lời: ASR tự nhiên loại bỏ từ đệm, loại bỏ lặp và tái cấu trúc ngữ nghĩa, tạo ra văn bản có cấu trúc mạch lạc và trôi chảy hơn.
Chuyển lời chính xác theo từng người nói: xuất đầu-cuối nhãn người nói, dấu thời gian và văn bản, vượt trội toàn diện so với hệ thống liên kết Fun-ASR.
Nâng cấp khả năng hiểu âm thanh: ASR-Next hiểu cảm xúc, âm thanh môi trường và âm thanh máy móc, chuyển từ “văn bản chuyển lời” sang “hiểu âm thanh hoàn chỉnh”.
Tích hợp năng lực sáng tạo: TTS-Next tạo một lần giọng người, hiệu ứng âm thanh và âm thanh môi trường, duy trì nhất quán chất giọng và cảm xúc của nhiều nhân vật, thay thế quy trình hậu kỳ cần nhiều người phối hợp.
Tương tác thời gian thực như người thật: nghe và nói song song theo cơ chế song công toàn phần, hỗ trợ chen lời và ngắt, có thể nhận biết cảm xúc và gọi công cụ để hoàn thành nhiệm vụ.
Độ trễ thấp, hiệu suất cao: thời gian phản hồi ký tự đầu tiên của nhận dạng dạng luồng khoảng 160 mili giây; Realtime sử dụng chưng cất đa giáo viên để cân bằng độ trễ thấp và năng lực suy luận.
06Địa chỉ dự án Qwen-Audio-3.1
Bản demo trực tuyến: Qwen-Audio-3.1-ASR:https://www.qianwenai.com/models/qwen-audio-3.1-asr-flash
Qwen-Audio-3.1-TTS:https://www.qianwenai.com/models/qwen-audio-3.1-tts-flash
Qwen-Audio-3.1-TTS-Next:https://www.qianwenai.com/models/qwen-audio-3.1-tts-next
Qwen-Audio-3.1-Realtime:https://www.qianwenai.com/models/qwen-audio-3.1-realtime-plus
07Các kịch bản ứng dụng của Qwen-Audio-3.1
Biên bản cuộc họp và ghi chép phỏng vấn: sử dụng tính năng chuyển lời theo từng người nói và dấu thời gian của ASR để tự động tạo bản ghi có cấu trúc “ai đã nói gì vào lúc nào”, đồng thời tự nhiên biên tập và loại bỏ các yếu tố khẩu ngữ, nâng cao đáng kể hiệu suất cuộc họp.
Sáng tạo podcast và sách nói: sử dụng TTS-Next để tạo một lần bản âm thanh hoàn chỉnh gồm hội thoại của nhiều người, hiệu ứng âm thanh và âm thanh môi trường; duy trì nhất quán chất giọng và cảm xúc của nhiều nhân vật, giảm nhu cầu phối hợp giữa người dẫn, kỹ sư âm thanh và kỹ sư hòa âm.
Tổng đài thoại thời gian thực/trợ lý thông minh: dựa trên khả năng tương tác song công toàn phần và nhận biết cảm xúc của Realtime để xây dựng tổng đài giọng nói có thể bị ngắt và biết đồng cảm, đồng thời gọi hệ thống nghiệp vụ trong hội thoại để thực hiện các tác vụ như tra cứu và đặt hàng.
Du lịch xuyên biên giới và giao tiếp đa ngôn ngữ: nhờ khả năng chuyển đổi thời gian thực giữa 30 ngôn ngữ và tổng hợp cùng một chất giọng ở nhiều ngôn ngữ, cung cấp trải nghiệm dịch và giao tiếp bằng giọng nói tự nhiên, trôi chảy cho lập kế hoạch du lịch, thương mại điện tử xuyên biên giới và hội nghị quốc tế.
Phần cứng AI thông minh: kết hợp với các thiết bị như QwenNote và kính AI Qianwen, người dùng không cần mở máy tính hay điện thoại mà có thể trực tiếp dùng giọng nói để khởi tạo nhiệm vụ, bổ sung điều kiện và theo dõi tiến độ, biến giọng nói thành cổng truy cập tự nhiên cho phần cứng AI.
© Tuyên bố miễn trừ trách nhiệm: tên miền và nội dung được liên kết có thể thay đổi theo thời gian. AIEZZ không kiểm soát các trang web của bên thứ ba. Hãy tự đánh giá nội dung bên ngoài và các rủi ro liên quan.
Đánh giá của người dùng0