
- Lượt truy cập hàng tháng
- 0
- Giá
- Chưa đặt
- Được liệt kê
- —
- Đã cập nhật
- 2026-09-28
01R2T2 là gì
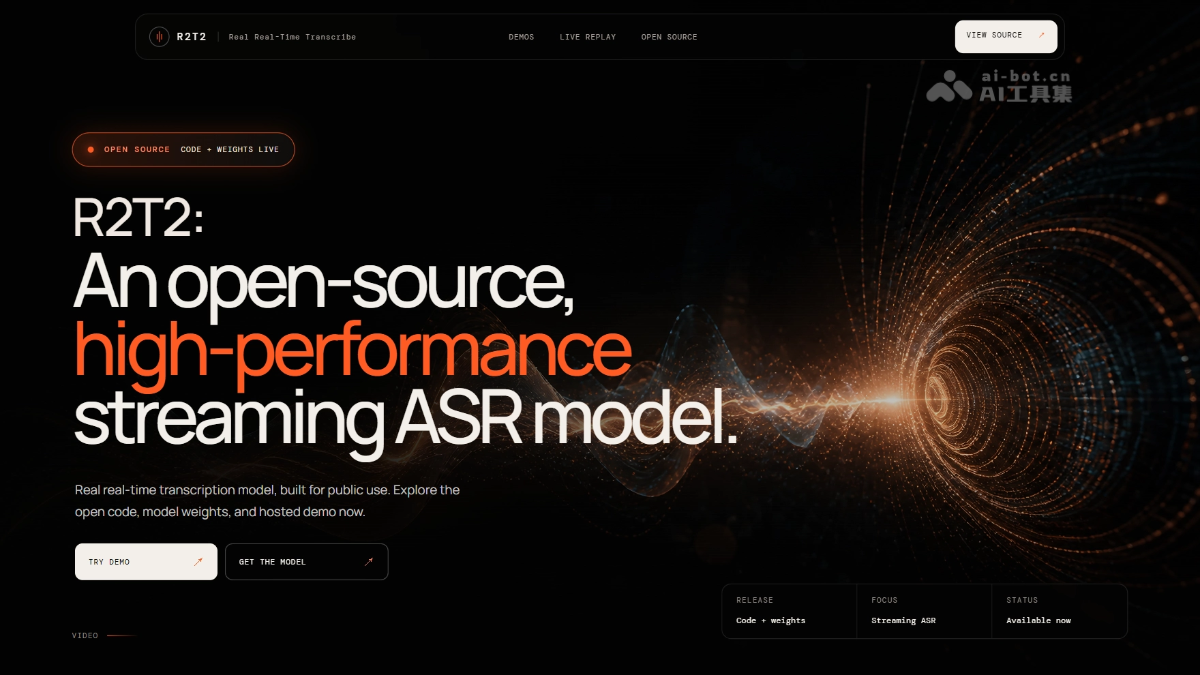
R2T2 là mô hình nhận dạng giọng nói phát trực tuyến thực sự với độ trễ thấp do NetEase Youdao phát hành mã nguồn mở, tên đầy đủ là Real Real-Time Transcription, được xây dựng trên Qwen3-ASR. R2T2 sử dụng cơ chế append-only, văn bản đã hiển thị sẽ không bị sửa lại, hỗ trợ chia khối có thể điều chỉnh từ 80ms–2s, tối ưu cho tiếng Trung và tiếng Anh cùng ngữ cảnh từ khóa nóng, có độ trễ trung bình khoảng 200–600ms, cung cấp các backend như vLLM, Transformers và llama.cpp/GGUF, phù hợp với phụ đề thời gian thực, voice Agent và giao diện đầu vào cho phiên dịch đồng thời.
02Các tính năng chính của R2T2
Nhận dạng phát trực tuyến thực sự: liên tục nhận âm thanh và xuất văn bản theo các chunk có thể điều chỉnh từ 80ms–2s.
Đã chốt thì không sửa: văn bản đã gửi sẽ không bị thay đổi, tránh hiện tượng phụ đề nhấp nháy và hành động của Agent bị viết lại.
Độ trễ thấp, độ chính xác cao: theo thông tin chính thức, độ trễ trung bình khoảng 200–600ms, độ chính xác khi phát trực tuyến gần với nhận dạng ngoại tuyến.
Từ khóa nóng/ngữ cảnh: hỗ trợ lời nhắc, từ ngữ lĩnh vực, tên riêng và các thông tin tiên nghiệm khác, nâng cao tỷ lệ nhận dạng từ hiếm.
Đa ngôn ngữ: tối ưu cho tiếng Trung và tiếng Anh, đồng thời duy trì khả năng xử lý tiếng Pháp, Đức, Ý, Nhật, Hàn, Nga, Tây Ban Nha, Ả Rập và các ngôn ngữ khác.
Triển khai đa backend: hỗ trợ vLLM, Transformers, llama.cpp/GGUF và có thể khởi chạy dịch vụ WebSocket.
03Nguyên lý kỹ thuật của R2T2
Theo dõi WeChat và trả lời “开源” để tham gia nhóm trao đổi dự án AI mã nguồn mở
Nền tảng mô hình: R2T2 dựa trên Qwen3-ASR, kế thừa năng lực mã hóa âm thanh và mô hình hóa chuỗi của mô hình này, đồng thời được huấn luyện có ràng buộc cho đầu ra phát trực tuyến.
Học tiền tố ổn định: trong quá trình huấn luyện, mô hình sử dụng stable-prefix, căn chỉnh thời gian bắt buộc, phân đoạn âm thanh cấp token và các phương pháp tạo dữ liệu khác, giúp mô hình học cách xác định “những tiền tố nào đã đủ ổn định để xuất ra”.
Giải mã Commit/Wait: mỗi khi nhận một đoạn âm thanh nhỏ, mô hình trước tiên đánh giá tiền tố ổn định hiện tại; nếu đủ ổn định thì commit thành văn bản không thể sửa, nếu chưa đủ thì wait để tiếp tục lưu thêm ngữ cảnh.
Sinh có điều kiện theo ngữ cảnh: chỉ sử dụng tiền tố ổn định làm điều kiện cho dự đoán tiếp theo, vừa cung cấp đủ ràng buộc ngữ nghĩa vừa đảm bảo đầu ra trước đó không bị âm thanh tiếp theo đảo ngược.
Điều chỉnh độ trễ–độ chính xác: thông qua các tham số như kích thước chunk và độ dài phần cuối/cửa sổ quay lui để kiểm soát thông lượng, độ trễ và khả năng chịu lỗi; chunk nhỏ nhanh hơn nhưng rủi ro cao hơn, chunk lớn ổn định hơn nhưng chậm hơn.
04Cách sử dụng R2T2
Sao chép kho lưu trữ: git clone https://github.com/netease-youdao/Confucius4-R2T2.git。
Tạo môi trường cô lập: dùng Conda hoặc uv để tạo môi trường Python 3.12 rồi chạy pip install -e ., hoặc dùng trực tiếp Docker chính thức qwenllm/qwen3-asr。
Tải trọng số: tùy backend, chọn Confucius4-R2T2 hoặc Confucius4-R2T2-GGUF trên HF/ModelScope。
Chạy thử ví dụ ngoại tuyến/phát trực tuyến: ./run_example.sh audio.wav --model_path ... --infer_mode stream_vllm --language Chinese --chunk_size_ms 160。
Viết mã phát trực tuyến: tải R2T2ASRModel.LLM, gọi init_streaming_state(), sau đó lặp qua các chunk 16kHz và gọi streaming_transcribe(), cuối cùng gọi finish_streaming_transcribe()。
Triển khai trên CPU/llama.cpp: sử dụng chế độ stream_llama_hybrid của r2t2_llama hoặc chế độ stream_llama/onetime_llama。
Khởi chạy dịch vụ thời gian thực: dùng ./run_start_server.sh start --model_path ... --vad_model_path checkpoints/vad/Stream-VAD --port 8272 --gpu 0。
Kết nối máy khách: gửi PCM int16 mono 16kHz đến ws://localhost:8272/asr_stream_api_v1, khi kết thúc gửi YOUDAO_ONETIME_ASR_STREAM_EOS。
Điều chỉnh tham số trải nghiệm: sử dụng language, chunk_size_ms, context/hotword và unfixed_token_num để cân bằng giữa độ trễ, độ chính xác và tỷ lệ nhận dạng thuật ngữ.
05Ưu điểm cốt lõi của R2T2
Phát trực tuyến thực sự và không sửa lại: văn bản đã xuất giống như “đã chốt thì không sửa”, tránh phụ đề nhấp nháy và việc Agent thực hiện nhầm.
Độ trễ thấp: theo thông tin chính thức, trung bình khoảng 200–600ms, phù hợp với phụ đề thời gian thực, phiên dịch đồng thời và voice Agent.
Có thể điều chỉnh độ trễ/độ chính xác: hỗ trợ chia khối từ 80ms–2s, cho phép chuyển đổi giữa tốc độ và độ ổn định tùy theo bối cảnh.
Năng lực ngoại tuyến mạnh: việc bổ sung ràng buộc phát trực tuyến không làm giảm đáng kể độ chính xác nhận dạng ngoại tuyến, một mô hình có thể đáp ứng cả hai loại tác vụ.
Nền tảng và hệ sinh thái mạnh: dựa trên Qwen3-ASR; sau khi mã nguồn mở, nhanh chóng xuất hiện các bản tương thích với GGUF, llama.cpp, Core ML và công cụ ngoại tuyến.
Thân thiện với triển khai sản xuất: cung cấp backend vLLM, Transformers, llama.cpp và dịch vụ WebSocket, thuận tiện tích hợp vào hệ thống sản xuất.
Tiên nghiệm đầu vào có thể kiểm soát: hỗ trợ lời nhắc ngữ cảnh/từ khóa nóng, nâng cao tỷ lệ nhận dạng tên người, tên sản phẩm và thuật ngữ.
Phủ nhiều ngôn ngữ: tối ưu cho tiếng Trung và tiếng Anh, đồng thời duy trì khả năng nhận dạng phát trực tuyến đa ngôn ngữ.
06Trang web chính thức của dự án R2T2
Trang web chính thức: https://r2t2.ai/
Kho GitHub: https://github.com/netease-youdao/Confucius4-R2T2
Kho mô hình HuggingFace: https://huggingface.co/netease-youdao/Confucius4-R2T2
07Các trường hợp sử dụng R2T2
Phụ đề cuộc họp thời gian thực: xuất phụ đề hoàn chỉnh đồng thời với lời nói, giảm ảnh hưởng khi đọc do phụ đề bị sửa lại.
Điểm vào lệnh cho Voice Agent: nhận dạng ổn định những câu nói tự sửa như “chuyển 300 thành 3.000”, giảm nguy cơ Agent thực hiện nhầm.
Tương tác giọng nói trên xe/thiết bị thông minh: xuất văn bản lệnh không thể thu hồi trong điều kiện yêu cầu độ trễ thấp, phù hợp với các tình huống dẫn đường, gọi điện và điều khiển xe.
Hỗ trợ thời gian thực cho trung tâm cuộc gọi: vừa chuyển lời nói thành văn bản vừa gửi gợi ý cho nhân viên, cân bằng giữa độ trễ, từ khóa thuật ngữ và yêu cầu tuân thủ khi triển khai riêng tư.
Ghi chép bài giảng/khả năng tiếp cận: cung cấp luồng chuyển lời nói thành văn bản ổn định cho người khiếm thính hoặc các tình huống ghi chú, giảm chi phí do văn bản nhấp nháy và phải chỉnh sửa sau đó.
© Tuyên bố miễn trừ trách nhiệm: tên miền và nội dung được liên kết có thể thay đổi theo thời gian. AIEZZ không kiểm soát các trang web của bên thứ ba. Hãy tự đánh giá nội dung bên ngoài và các rủi ro liên quan.
Đánh giá của người dùng0